7 Seq 序列集合
笔记衔接前序《Scala 访问权限、包、集合与迭代器》,严格匹配课程体系,针对有 Java 基础的大数据专业大学生设计,全程Java 语法对比 + 课程配套源码拆解 + Spark 大数据场景应用 + 避坑指南 + 作业全解析。Seq 序列是 Scala 最核心、最常用的集合类型,Spark RDD/DataFrame 的绝大多数算子设计完全对标 Seq 的高阶函数,是大数据开发必须熟练掌握的核心基础。
- 前置知识:Scala 集合体系、函数式编程、面向对象基础
- 开发环境:JDK1.8+、Scala2.12.x、IDEA + Scala 插件
- 核心学习目标:
- 掌握 Scala 集合顶层特质
Traversable与Iterable的核心特性,明确 Seq 的整体继承体系- 熟练掌握 Seq 的通用操作方法,理解集合视图 view 的懒加载特性与应用场景
- 深入理解
IndexedSeq与LinearSeq两大分支的核心差异,掌握各实现类的适用场景- 熟练掌握 List、Vector、Array、ArrayBuffer 等核心集合的用法与特性,明确可变与不可变集合的使用原则
- 独立完成课程配套作业,掌握 Seq 集合的高阶操作与实战技巧
第一章 Scala 集合顶层特质与 Seq 整体概述
Scala 所有集合都继承自两大顶层特质:Traversable和Iterable,Seq 是这两大特质下最核心的序列集合分支,对应 Java 中的List接口,但提供了更丰富的特性与更强大的函数式编程能力。
1.1 集合顶层特质
1.1.1 Traversable 特质(在 Scala 2.13 之后已经被移除)
Traversable是 Scala 所有集合的最顶端特质,是所有集合的根,核心特性如下:
- 仅包含一个抽象方法
foreach,集合的所有其他方法都基于foreach实现; - 定义了集合通用的遍历、转换、过滤、聚合等上百个非抽象方法,所有继承该特质的集合都可直接使用;
- 核心设计思想:定义了集合 “可遍历” 的通用能力,只要实现了
foreach方法,就具备了所有集合通用操作能力。
1.1.2 Iterable 特质(顶层特质)
Iterable继承自Traversable,在其基础上增加了迭代器特性,核心特性如下:
- 核心抽象方法是
iterator,用于返回一个迭代器,逐个交出集合的元素; - 基于迭代器实现了更丰富的遍历、切片、拉链等操作,比
Traversable更灵活; - 所有 Scala 集合都直接或间接继承自
Iterable,Seq、Set、Map 三大分支都基于该特质扩展。
1.2 Seq 序列整体概述
Seq 是一个特质,代表元素有序、可重复、带索引的序列集合,索引从 0 开始,每个元素对应唯一的索引,是 Scala 中最常用的集合类型。
1.2.1 Seq 的核心继承体系
Seq 主要分为三大子特质,对应不同的应用场景,完整继承关系如下:
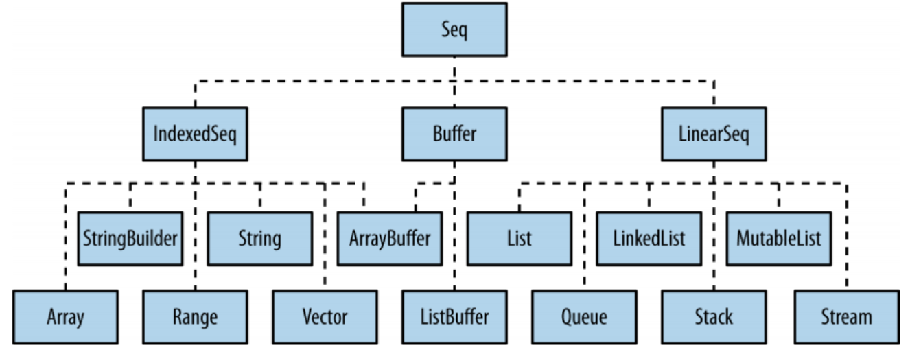
Seq(序列顶级特质)
├─ IndexedSeq(索引序列):支持高效的随机访问,通过索引直接定位元素
│  ├─ 不可变:Vector、String、Range、ArraySeq
│  └─ 可变:ArrayBuffer、ArraySeq、StringBuilder
├─ LinearSeq(线性序列):基于链表实现,顺序访问高效,随机访问效率低
│  ├─ 不可变:List、LazyList(Stream)、Queue
│  └─ 可变:ListBuffer、LinkedList、MutableList、Queue、Stack
└─ Buffer(缓冲序列):可变序列,支持高效的元素增删改操作
   └─ 可变:ArrayBuffer、ListBuffer
1.2.2 Seq 的两大核心分支对比
| 分支 | 核心特性 | 访问效率 | 适用场景 | 代表实现类 |
|---|---|---|---|---|
| IndexedSeq | 基于数组 / 向量实现,元素在内存中连续存储 | 随机访问 O (1),头部 / 中间增删 O (n) | 频繁随机读取、少增删的场景 | 不可变 Vector、可变 ArrayBuffer |
| LinearSeq | 基于链表实现,元素在内存中不连续存储,通过指针关联 | 随机访问 O (n),头部增删 O (1) | 频繁头部增删、少随机读取的场景 | 不可变 List、可变 ListBuffer |
1.2.3 集合类型选择指南
课程中给出了通用的集合类型选择原则,也是 Scala 官方推荐的最佳实践:
| 场景 | 不可变集合 | 可变集合 |
|---|---|---|
| 频繁随机索引访问 | Vector | ArrayBuffer |
| 频繁头部增删、线性遍历 | List | ListBuffer |
| 无需区分索引 / 线性,通用场景 | Seq | Buffer |
大数据场景核心原则:优先使用不可变集合,不可变集合线程安全、无副作用,完美适配 Spark 的分布式不可变 RDD 模型,避免并发修改导致的数据异常;仅在局部高频增删的场景下使用可变集合,用完立即转为不可变集合。
1.2.4 与 Java List 的核心差异
| 特性 | Scala Seq | Java List |
|---|---|---|
| 可变性 | 默认不可变,需手动导入可变集合 | 默认可变,不可变需特殊处理 |
| 函数式支持 | 内置上百个高阶函数,原生支持 map/flatMap/filter/reduce 等 | Java8 前无 Lambda 支持,需通过循环实现,Java8 + 仅提供基础 Stream 支持 |
| 索引访问 | 用集合(索引),语法更简洁 | 用集合.get(索引) |
| 实现类 | 分为 IndexedSeq 和 LinearSeq 两大分支,针对不同场景优化 | 主要实现类为 ArrayList 和 LinkedList,无明确的特质分层 |
| 不可变性 | 不可变集合修改操作返回新集合,原集合不变 | 不可变 List 仅支持读操作,调用修改方法会直接抛出异常 |
第二章 Seq 通用操作
Seq 的所有通用操作都继承自Traversable和Iterable特质,所有 Seq 实现类都可直接使用,是 Scala 集合函数式编程的核心,对应课程源码RunTraserbale.scala。
2.1 元素获取操作
| 方法 | 作用 | 注意事项 |
|---|---|---|
head | 获取集合第一个元素 | 空集合会抛出NoSuchElementException |
last | 获取集合最后一个元素 | 空集合会抛出NoSuchElementException |
headOption | 获取第一个元素,返回 Option 类型 | 空集合返回 None,非空返回 Some (元素),安全无异常 |
lastOption | 获取最后一个元素,返回 Option 类型 | 同上,避免空指针异常 |
tail | 获取除第一个元素外的剩余集合 | 空集合抛出异常 |
init | 获取除最后一个元素外的剩余集合 | 空集合抛出异常 |
集合(索引) | 根据索引获取元素 | 索引越界抛出异常,对应 Java 的get(index) |
find(条件) | 查找第一个满足条件的元素,返回 Option 类型 | 找不到返回 None,找到返回 Some (元素) |
代码示例(对应 RunTraserbale.scala)
object RunTraserbale {
  def main(args: Array[String]): Unit = {
    val t1 = Traversable(1, 2, 3, 5, 4)
    // 基础元素获取
    println(s"head=${t1.head},last=${t1.last}") // 输出:head=1,last=4
    println(s"tail=${t1.tail},init=${t1.init}") // 输出:tail=List(2, 3, 5, 4),init=List(1, 2, 3, 5)

    // 安全获取,避免空集合异常
    val t2 = Traversable()
    println(s"head=${t1.headOption.getOrElse(0)},last=${t1.lastOption.getOrElse(0)}") // 输出:head=1,last=4

    // 条件查找
    val t3 = t1.find(x => x > 3)
    println(s"t3=${t3.get}") // 输出:t3=5
  }
}
2.2 集合遍历操作
Scala 提供三种遍历集合的方式,所有 Seq 集合通用:
- foreach 遍历:最常用的函数式遍历方式,对每个元素执行指定操作,无返回值;
- for 循环遍历:支持带条件的遍历、yield 生成新集合;
- 迭代器遍历:通过 iterator 迭代器遍历,适合超大集合的低内存遍历。
代码示例(对应 RunTraserbale.scala)
object RunTraserbale {
  def main(args: Array[String]): Unit = {
    val fruits = Traversable("banana", "apple", "orange")

    // 1. foreach遍历
    fruits.foreach(println(_))

    // 2. for循环遍历
    for (fruit <- fruits) println(fruit)

    // 3. for + yield 遍历并生成新集合
    val upperFruits = for (fruit <- fruits) yield fruit.toUpperCase
    println(s"upper=${upperFruits}") // 输出:upper=List(BANANA, APPLE, ORANGE)

    // 4. 迭代器遍历
    val it = fruits.toIterator
    while (it.hasNext) println(it.next())
  }
}
2.3 集合视图 View(懒加载)
Scala 的集合视图view类似于数据库的视图,核心特性是懒加载,与lazy关键字功能一致:
- 普通集合的
map/filter等转换操作会立即执行,生成中间结果集合,占用内存; - 视图的转换操作不会立即执行,只有在真正使用元素时才会执行,省略了中间结果,节省内存;
- 适用场景:超大集合的多步转换操作、需要延迟执行的场景、避免中间结果占用大量内存。
代码示例(对应 RunTraserbale.scala)
object RunTraserbale {
  def main(args: Array[String]): Unit = {
    val t5 = Traversable(1, 2, 3)
    // 普通map:立即执行,生成新集合
    val initMap = t5.map(_ * 2)
    println(s"initMap=$initMap") // 输出:initMap=List(2, 4, 6)

    // view视图:懒加载,不会立即执行map操作
    val view = t5.view.map(_ * 2)
    println(s"view=$view") // 输出:view=SeqView(...),未执行计算
    // 只有在foreach/force时才会真正执行
    view.foreach(println(_)) // 此时才执行*2操作,输出2、4、6

    // 超大集合场景:view避免中间结果占用内存
    val bigList = (1 to 1000000).toList
    // 多步转换:普通集合会生成3个中间集合,占用大量内存
    val result1 = bigList.map(_ * 2).filter(_ > 100).map(_ + 10)
    // view视图:不会生成中间集合,仅在最终使用时执行所有操作
    val result2 = bigList.view.map(_ * 2).filter(_ > 100).map(_ + 10).force
  }
}
大数据场景应用:Spark 的 RDD 转换算子(map/filter 等)就是懒加载的,与 Scala 的 view 设计思想完全一致,只有调用行动算子时才会真正执行计算,避免了中间结果的内存占用。
第三章 Seq 核心实现类详解
Seq 分为不可变和可变两大分支,课程中重点讲解了 List、Vector、Array、ArrayBuffer、ListBuffer、Range、Stack、Queue 等核心实现类,对应源码RunList.scala、RunArray.scala。
3.1 不可变 Seq 核心实现类
不可变集合一旦创建,内容永远无法修改,所有修改操作都会返回一个全新的集合,原集合保持不变,线程安全、无副作用,是 Scala 默认使用的集合类型。
3.1.1 List(不可变线性链表)
List 是 Scala 最常用的不可变线性序列,基于链表实现,头部增删 O (1) 效率极高,随机访问 O (n) 效率低,适合频繁头部操作、顺序遍历的场景。
核心特性
- List 有两个核心组成部分:
Nil(空 List)和::( cons 操作符,用于在头部添加元素); - List 是递归结构,每个元素都包含当前值和指向后续 List 的指针;
- 不支持修改元素,不支持尾部高效增删,尾部添加元素需要遍历整个链表。
代码示例(对应 RunList.scala)
object RunList {
  def main(args: Array[String]): Unit = {
    // 1. List构建:两种方式
    // 方式1:::操作符构建,必须以Nil结尾
    val l1 = 1 :: 2 :: 3 :: Nil
    // 方式2:直接调用List伴生对象
    val l2 = List(4, 5, 6)
    println(s"l1 head=${l1.head}, l1(2)=${l1(2)}") // 输出:l1 head=1, l1(2)=3

    // 2. 列表拼接
    // :: 是将整个列表作为一个元素添加到头部
    val l3 = l2 :: l1
    println(l3) // 输出:List(List(4, 5, 6), 1, 2, 3)
    // ::: 是将两个列表的元素拼接,对应Java的addAll
    val l4 = l2 ::: l1
    println(l4) // 输出:List(4, 5, 6, 1, 2, 3)

    // 3. 懒加载List:Stream(Scala2.13+改为LazyList)
    // 只有在使用元素时才会加载,避免一次性加载所有元素
    val s = 1 #:: 2 #:: 3 #:: Stream.empty
    val s2 = s.map(x => x + 1)
    println(s2, s2(2)) // 输出:Stream(2, ?),4
    println(s.force) // 强制加载所有元素,输出:Stream(1, 2, 3)
  }
}
3.1.2 Vector(不可变索引序列)
Vector 是 Scala 为解决 List 随机访问效率低下的问题而设计的不可变索引序列,随机访问 O (1) 效率极高,增删改操作也有优秀的性能,是通用场景下不可变集合的首选。
核心特性
- 基于前缀树实现,元素在内存中分块存储,兼顾了随机访问和增删性能;
- 支持高效的随机访问、头部 / 中间 / 尾部增删操作,性能波动极小;
- 是 Scala 不可变 IndexedSeq 的默认实现,
Vector(1,2,3)直接创建 Vector 实例。
代码示例(对应 RunList.scala)
object RunList {
  def main(args: Array[String]): Unit = {
    val v = Vector(1, 2, 2, 3)
    // 随机访问,效率极高
    println(v(1)) // 输出:2
    // 更新元素,返回新的Vector,原集合不变
    val v1 = v.updated(0, 99)
    println(s"v1=$v1") // 输出:v1=Vector(99, 2, 2, 3)
    println(s"原集合v=$v") // 输出:原集合v=Vector(1, 2, 2, 3)
  }
}
3.1.3 Array(不可变数组)
Scala 的 Array 与 Java 数组完全兼容,底层就是 Java 数组,长度不可变,元素内容可变,是唯一与 Java 原生类型无缝对接的集合。
核心特性
- 长度一旦创建就无法修改,但是数组内的元素值可以修改;
- 与 Java 数组完全兼容,可直接在 Scala 和 Java 代码中互相传递,无需转换;
- 支持高效的随机访问,是数值计算、大数据处理中最常用的数组类型。
代码示例(对应 RunArray.scala)
object RunArray {
  def main(args: Array[String]): Unit = {
    // 1. 数组创建的四种方式
    // 方式1:指定类型和长度,元素初始化为默认值
    val arr1 = new Array[Int](sslocal://flow/file_open?url=3&flow_extra=eyJsaW5rX3R5cGUiOiJjb2RlX2ludGVycHJldGVyIn0=)
    // 方式2:直接指定元素,自动推断类型
    val arr2 = Array(1, 2, 3)
    // 方式3:Range填充
    val r1 = Array.range(1, 5) // 生成1-4的数组
    val r2 = Array.range(1, 5, 2) // 步长2,生成1、3
    // 方式4:fill填充
    val r3 = Array.fill(2)("scala") // 生成2个"scala"的数组
    // 方式5:tabulate按函数生成
    val r5 = Array.tabulate(3)(n => n * n) // 生成0、1、4

    // 2. 元素修改与访问
    arr1(0) = 7
    arr1(1) = 8
    arr1(2) = 9
    arr1.foreach(x => print(x + ",")) // 输出:7,8,9,

    // 3. 多维数组
    // 方式1:ofDim创建2行2列的二维数组
    val marr1 = Array.ofDim[String](sslocal://flow/file_open?url=2%2C+2&flow_extra=eyJsaW5rX3R5cGUiOiJjb2RlX2ludGVycHJldGVyIn0=)
    marr1(0)(0) = "a"
    marr1(0)(1) = "b"
    marr1(1)(0) = "c"
    marr1(1)(1) = "d"
    // 方式2:直接嵌套创建
    var marr2 = Array(Array(1, 2), Array(3, 4))
  }
}
3.1.4 Range(不可变数值序列)
Range 是一个特殊的不可变序列,用于表示一个有序的数值区间,不会存储所有元素,仅存储起始值、结束值、步长,内存占用极低,常用于 for 循环、数据填充场景。
代码示例
object RangeDemo {
  def main(args: Array[String]): Unit = {
    // 1 to 10:生成1到10的Range,步长1,包含10
    val r1 = 1 to 10
    // 1 until 10:生成1到9的Range,步长1,不包含10
    val r2 = 1 until 10
    // 带步长的Range
    val r3 = 1 to 10 by 2 // 1、3、5、7、9
    // 反向Range
    val r4 = 10 to 1 by -1 // 10、9、...、1

    // 常用于for循环
    for (i <- 1 to 5) println(i)
  }
}
3.2 可变 Seq 核心实现类
可变集合支持在原集合上直接修改元素、增删内容,不会生成新的集合,性能更高,但非线程安全,仅适合局部单线程的高频增删场景。
3.2.1 ArrayBuffer(可变索引数组)
ArrayBuffer 是 Scala 最常用的可变序列,对应 Java 的ArrayList,基于数组实现,随机访问 O (1) 效率极高,尾部增删 O (1) amortized 效率,是通用场景下可变集合的首选。
代码示例(对应 RunArray.scala)
import scala.collection.mutable.ArrayBuffer

object RunArray {
  def main(args: Array[String]): Unit = {
    // 1. 创建ArrayBuffer
    val ab1 = ArrayBuffer(1, 2, 3)
    val ab2 = new ArrayBuffer[String](sslocal://flow/file_open?url=1&flow_extra=eyJsaW5rX3R5cGUiOiJjb2RlX2ludGVycHJldGVyIn0=)

    // 2. 添加元素
    ab2 += "a" // 尾部添加单个元素
    ab2 += ("b", "c") // 尾部添加多个元素
    ab2 ++= Seq("s1", "s2") // 尾部添加整个集合
    ab2.append("append1", "append2") // append方法添加

    // 3. 删除元素
    ab2 -= "b" // 删除单个元素
    ab2 -= ("d", "e", "b") // 删除多个元素,不存在的忽略
    ab2 --= Seq("s1", "s2") // 删除整个集合的元素
    ab2.remove(0) // 删除指定索引的元素
    ab2.remove(1, 3) // 从索引1开始,删除3个元素
    ab2.clear() // 清空所有元素

    // 4. 修改与访问
    ab1(0) = 99 // 直接修改指定索引的元素
    println(ab1(0)) // 访问指定索引的元素
  }
}
3.2.2 ListBuffer(可变线性链表)
ListBuffer 对应 Java 的LinkedList,基于双向链表实现,头部 / 尾部增删 O (1) 效率极高,随机访问 O (n) 效率低,适合频繁头尾增删、少随机访问的场景,可高效转为 List。
代码示例(对应 RunList.scala)
import scala.collection.mutable.ListBuffer

object RunList {
  def main(args: Array[String]): Unit = {
    val lb1 = ListBuffer(7, 8, 9)
    // 修改元素
    lb1(0) = 99
    println(lb1) // 输出:ListBuffer(99, 8, 9)
    // 增删元素
    lb1 += 10
    lb1 -= 8
    // 转为不可变List
    val list = lb1.toList
  }
}
3.2.3 Stack(栈)与 Queue(队列)
- Stack 栈:后进先出(LIFO)的数据结构,提供
push(入栈)、pop(出栈)、top(查看栈顶)方法; - Queue 队列:先进先出(FIFO)的数据结构,提供
enqueue(入队)、dequeue(出队)方法。
第四章 Seq 高级操作
4.1 折叠操作 fold /: :\
折叠操作是 Seq 集合的核心聚合操作,分为左折叠和右折叠,课程中重点讲解了简化写法/:(左折叠)和:\(右折叠)。
| 操作 | 语法 | 说明 |
|---|---|---|
| 左折叠 | (初始值 /: 集合)(操作函数) | 从左到右遍历集合,从初始值开始,依次执行操作函数,等价于foldLeft |
| 右折叠 | (集合 :\ 初始值)(操作函数) | 从右到左遍历集合,从初始值开始,依次执行操作函数,等价于foldRight |
代码示例(对应 RunList.scala)
object RunList {
  def main(args: Array[String]): Unit = {
    val words = List("scala", "is", "good")
    // 左折叠:实现字符串拼接,等价于words.mkString(" ")
    val s3 = (" " /: words)(_ + " " + _)
    println(s3) // 输出:  scala is good
    // 优化:避免开头空格
    val s4 = (words.head /: words.tail)(_ + " " + _)
    println(s4) // 输出:scala is good

    // 左折叠:列表扁平化拼接
    val listList = List(List("1", "2"), List("3", "4"))
    val flatLeft = (List /: listList)(_ ::: _)
    println(flatLeft) // 输出:List(1, 2, 3, 4)

    // 右折叠:列表扁平化拼接
    val flatRight = (listList :\ List)(_ ::: _)
    println(flatRight) // 输出:List(1, 2, 3, 4)
  }
}
4.2 拉链操作 zipped
zipped方法用于将多个集合的元素按位置配对,进行联合操作,比普通的zip方法更高效,支持直接传入函数对配对元素进行处理。
代码示例(对应 RunList.scala)
object RunList {
  def main(args: Array[String]): Unit = {
    // 两个列表配对,对应位置元素相乘
    val zip1 = (List(1, 2), List(3, 4, 5)).zipped.map(_ * _)
    println(s"zip1=$zip1") // 输出:zip1=List(3, 8),以最短的列表为准
  }
}
第五章 课后作业全解析
对应课程配套作业文档,包含简答题与编程题全解析,所有代码可直接复制运行。
一、简答题
(1)Harry Hacker 写了一个从命令行接受一系列文件名的程序。对每个文件名,他都启动一个新的线程来读取文件内容并更新一个字母出现的频率映射,声明为:
val frequencies = new scala.collection.mutable.HashMap[Char,Int] with scala.collection.mutable.SynchronizedMap[Char,Int]当读到字母 c 时,他调用:
frequencies(c) = frequencies(c).getOrElse(c,0) + 1为什么这样得不到正确答案?
答:这段代码在多线程环境下无法得到正确结果,核心原因是复合操作的非原子性,具体分析如下:
- SynchronizedMap 的局限性:
SynchronizedMap仅能保证单个方法(如get、put、apply、update)的原子性和线程安全,无法保证复合操作的原子性。 - 复合操作的拆分:
frequencies(c) = frequencies(c).getOrElse(c,0) + 1这行代码会被拆分为三个独立的步骤:- 步骤 1:读取操作
frequencies(c).getOrElse(c,0),获取当前字母的计数; - 步骤 2:计算操作
+1,对计数加 1; - 步骤 3:写入操作
frequencies(c) = 新值,将新的计数写回 Map。
- 步骤 1:读取操作
- 多线程竞态条件:在多线程环境下,多个线程可能同时执行步骤 1,读取到同一个字母的相同旧值,然后分别执行加 1 和写入操作,最终导致多次加 1 的结果被覆盖,计数丢失,无法得到正确的总频率。
- 解决方案:
- 方案 1:对整个复合操作加锁,保证整个读 - 改 - 写过程的原子性;
- 方案 2:使用线程安全的原子操作方法,如
frequencies.updateWith(c)(old => Some(old.getOrElse(0) + 1)),该方法是原子性的; - 方案 3:使用并发集合,如 Java 的
ConcurrentHashMap,其提供的merge方法可保证原子性的更新操作。
二、编程题
(1)编写一个函数,从一个整型链表里去除所有零值。
import scala.collection.mutable.ListBuffer

object Homework1 {
  /**
   * 从不可变List中去除所有零值,返回新的List
   * @param list 输入的整型链表
   * @return 去除零值后的新List
   */
  def removeZero(list: List[Int]): List[Int] = {
    // 函数式写法:filter过滤非零元素,简洁高效
    list.filter(_ != 0)
  }

  /**
   * 从可变ListBuffer中原地去除所有零值
   * @param listBuffer 输入的可变整型链表
   */
  def removeZeroInPlace(listBuffer: ListBuffer[Int]): Unit = {
    // 原地过滤,直接修改原集合
    listBuffer --= listBuffer.filter(_ == 0)
  }

  def main(args: Array[String]): Unit = {
    // 测试不可变List
    val testList = List(1, 0, 2, 0, 3, 0, 4, 5, 0)
    val result = removeZero(testList)
    println(s"原列表:$testList")
    println(s"去零后:$result") // 输出:List(1, 2, 3, 4, 5)

    // 测试可变ListBuffer
    val testBuffer = ListBuffer(0, 0, 1, 0, 2, 0, 3)
    removeZeroInPlace(testBuffer)
    println(s"原地去零后:$testBuffer") // 输出:ListBuffer(1, 2, 3)
  }
}
(2)编写一个函数,接受一个字符串的集合,以及一个从字符串到整数值的映射。返回整型的集合,其值为能和集合中某个字符串相对应的映射的值。举例来说,给定 Array ("Tom","Fred","Harry") 和 Map ("Tom"->3,"Dick"->4,"Harry"->5), 返回 Array (3,5)。提示:用 flatMap 将 get 返回的 Option 值组合在一起。
object Homework2 {
  /**
   * 获取字符串集合在映射中对应的整数值
   * @param strs 字符串集合
   * @param map 字符串到整数的映射
   * @return 对应的整数值数组
   */
  def getCorrespondingValues(strs: Array[String], map: Map[String, Int]): Array[Int] = {
    // 按题目要求,使用flatMap + get方法实现
    // map.get(key)返回Option,flatMap会自动过滤None,展开Some中的值
    strs.flatMap(str => map.get(str))
  }

  def main(args: Array[String]): Unit = {
    // 测试用例
    val names = Array("Tom", "Fred", "Harry")
    val nameMap = Map("Tom" -> 3, "Dick" -> 4, "Harry" -> 5)
    val result = getCorrespondingValues(names, nameMap)
    println(s"输入字符串数组:${names.mkString(",")}")
    println(s"映射关系:$nameMap")
    println(s"结果数组:${result.mkString(",")}") // 输出:3,5
  }
}
(3)实现一个函数,与 mkString 相同,使用 reduceLeft。
object Homework3 {
  /**
   * 模拟mkString方法,使用reduceLeft实现
   * @param seq 输入的序列
   * @param separator 元素分隔符,默认空字符串
   * @param prefix 前缀,默认空字符串
   * @param suffix 后缀,默认空字符串
   * @return 拼接后的字符串
   */
  def myMkString(seq: Seq[Any], separator: String = "", prefix: String = "", suffix: String = ""): String = {
    seq match {
      // 空序列:返回前缀+后缀
      case Nil => prefix + suffix
      // 非空序列:先将所有元素转为字符串,再用reduceLeft按分隔符拼接,最后加前缀后缀
      case _ =>
        val strSeq = seq.map(_.toString)
        val content = strSeq.reduceLeft((acc, curr) => acc + separator + curr)
        prefix + content + suffix
    }
  }

  def main(args: Array[String]): Unit = {
    val testSeq1 = List(1, 2, 3, 4, 5)
    val testSeq2 = List("scala", "is", "good")
    val emptySeq = Nil

    // 测试无分隔符
    println(myMkString(testSeq1)) // 输出:12345
    // 测试带分隔符
    println(myMkString(testSeq1, ",")) // 输出:1,2,3,4,5
    // 测试带前缀、后缀、分隔符
    println(myMkString(testSeq2, " ", "[", "]")) // 输出:[scala is good]
    // 测试空序列
    println(myMkString(emptySeq, ",", "(", ")")) // 输出:()

    // 与原生mkString对比,结果完全一致
    println(testSeq1.mkString(",") == myMkString(testSeq1, ",")) // 输出:true
  }
}
(4)编写一个函数,将 Double 数组转换成二维数组。传入列数作为参数。举例来说,Array (1,2,3,4,5,6) 和三列,返回 Array (Array (1,2,3),Array (4,5,6))。用 grouped 方法。
object Homework4 {
  /**
   * 将一维Double数组转为二维数组
   * @param arr 输入的一维Double数组
   * @param cols 二维数组的列数
   * @return 二维数组,不足一行的元素单独成一行
   */
  def arrayTo2D(arr: Array[Double], cols: Int): Array[Array[Double]] = {
    // 校验列数合法性
    if (cols <= 0) throw new IllegalArgumentException("列数必须大于0")
    // grouped(cols):将数组按指定大小分组,每个分组对应二维数组的一行
    arr.grouped(cols).toArray
  }

  def main(args: Array[String]): Unit = {
    // 测试用例1:刚好整除
    val testArr1 = Array(1, 2, 3, 4, 5, 6)
    val result1 = arrayTo2D(testArr1, 3)
    println("测试用例1结果:")
    result1.foreach(row => println(row.mkString(",")))
    // 输出:
    // 1.0,2.0,3.0
    // 4.0,5.0,6.0

    // 测试用例2:不能整除,剩余元素单独一行
    val testArr2 = Array(1, 2, 3, 4, 5, 6, 7)
    val result2 = arrayTo2D(testArr2, 3)
    println("\n测试用例2结果:")
    result2.foreach(row => println(row.mkString(",")))
    // 输出:
    // 1.0,2.0,3.0
    // 4.0,5.0,6.0
    // 7.0
  }
}
学习总结
- Seq 整体体系:Seq 是 Scala 最核心的序列集合,分为
IndexedSeq(随机访问高效)和LinearSeq(线性访问高效)两大分支,所有集合都继承自Traversable和Iterable两大顶层特质,具备通用的遍历、转换、聚合能力。 - 通用操作:Seq 提供了丰富的函数式操作方法,核心分为元素获取、遍历、转换、过滤、聚合五大类,集合视图 view 提供了懒加载能力,避免中间结果占用内存,其设计思想与 Spark RDD 的懒执行完全一致。
- 核心实现类:
- 不可变集合优先使用
Vector(通用场景)和List(频繁头部增删),线程安全、无副作用,完美适配 Spark 分布式场景; - 可变集合优先使用
ArrayBuffer(通用场景)和ListBuffer(频繁头尾增删),仅用于局部单线程的高频增删场景。
- 不可变集合优先使用
- 高级操作:折叠操作
foldLeft/foldRight是集合聚合的核心,可灵活实现各类累加、拼接、扁平化操作;zipped提供了高效的多集合配对操作,比普通zip更灵活。 - 大数据开发适配:Scala Seq 的函数式操作方法与 Spark RDD 的算子完全对标,掌握 Seq 的
map/flatMap/filter/reduce/grouped等方法,就掌握了 Spark 核心算子的使用逻辑,是后续大数据框架学习的核心基础。
下一章预习内容:Scala Map 集合与模式匹配。