6 访问权限、包、集合与迭代器
笔记衔接前序《Scala 继承、多态与 Trait》,严格匹配课程体系,针对有 Java 基础的大数据专业大学生设计,全程Java 语法对比 + 课程配套源码拆解 + Spark 大数据场景应用 + 避坑指南 + 作业全解析。Scala 访问权限、集合体系是 Spark/Flink 大数据开发的基础,Spark RDD 的算子设计完全基于 Scala 集合的函数式编程思想,迭代器更是大数据海量数据处理的核心工具,本节内容必须重点掌握。
前置知识:Scala 面向对象基础、函数式编程、类与 Trait
开发环境:JDK1.8+、Scala2.12.x、IDEA + Scala 插件
核心学习目标:
- 掌握 Scala 的 5 种访问权限控制符,明确与 Java 访问权限的核心差异
- 熟练掌握 Scala 包的定义、作用域与高级导入特性,解决类名冲突问题
- 深入理解 Scala 集合的整体体系,明确可变集合与不可变集合的核心差异与适用场景
- 掌握 Scala 迭代器的核心特性与常用方法,理解其在大数据海量数据处理中的价值
- 独立完成课程配套作业,掌握 Scala 包对象、集合互操作的实战技巧
第一章 Scala 访问权限控制
Scala 的访问权限控制比 Java 更精细、更灵活,提供了 5 种访问控制级别,核心设计思想是更严格的封装、更灵活的作用域控制,是编写规范、安全的 Scala 代码的基础。
1.1 Scala 与 Java 访问权限整体对比
Java 提供 4 种访问控制符:public > protected > default(包私有) > private;
Scala 无public关键字,提供 5 种访问控制级别,权限从大到小为:
默认访问权限 > protected[包名] > private[包名] > protected > private > private[this]
表格
| 访问控制符 | Scala 作用域 | Java 作用域 | 核心差异 |
|---|---|---|---|
| 无修饰符(默认) | 全局任何位置均可访问,等同于 Java 的public | 同包内可访问(包私有) | Scala 无public关键字,无修饰符即为全局公开 |
protected | 仅本类 + 子类可访问,同包内其他类不可访问 | 本类 + 子类 + 同包内其他类均可访问 | Scala 的protected权限比 Java 更严格,取消了同包访问权限 |
private | 仅本类 + 伴生对象可访问 | 仅本类内部可访问 | Scala 的private允许伴生对象访问,Java 不允许 |
private[this] | 仅当前对象内部可访问,同一个类的其他对象也无法访问 | 无对应特性 | Scala 独有,对象级别的私有,最严格的访问权限 |
private[包名] | 本类 + 指定包及其子包内可访问 | 无对应特性 | Scala 独有,包级别的作用域控制,灵活调整访问范围 |
1.2 成员属性与构造器的访问权限
Scala 的属性成员、方法、构造器均可通过访问控制符控制权限,课程配套源码Person0601.scala、Person0602.scala完整演示了各类访问权限的用法。
1.2.1 默认访问权限(等同于 Java public)
Scala 中没有public关键字,成员无任何访问修饰符时,即为默认全局公开权限,任何位置都可访问。
class Person0601 {
  // 无修饰符:默认访问权限,全局可访问
  val name = "xiaoming"
}

object Person0601 {
  def main(args: Array[String]): Unit = {
    val p = new Person0601()
    println(p.name) // 合法,全局可访问
  }
}
1.2.2 private 访问权限
private修饰的成员,仅能在本类内部和其伴生对象中访问,子类、外部类均无法访问,与 Java 的核心差异是允许伴生对象访问。
class Person0601 {
  // private:仅本类和伴生对象可访问
  private val city = "beijing"

  // 本类内部可访问
  println(s"internal city=${city}")
}

class p0601 extends Person0601 {
  // println(s"p0601 city=${this.city}") // 非法,子类无法访问父类的private成员
}

object Person0601 {
  def main(args: Array[String]): Unit = {
    val p = new Person0601()
    println(s"object city=${p.city}") // 合法,伴生对象可访问private成员
  }
}
1.2.3 protected 访问权限
protected修饰的成员,仅能在本类和其子类中访问,同包内的其他类无法访问,这是与 Java 最核心的差异(Java 同包内可访问)。
class Person0601 {
  // protected:仅本类和子类可访问
  protected var age = 10

  // 本类内部可访问
  println(s"internal age=${age}")
}

class p0601 extends Person0601 {
  // 合法,子类可访问父类的protected成员
  println(s"p0601 age=${this.age}")
}

object Person0601 {
  def main(args: Array[String]): Unit = {
    val p = new Person0601()
    println(s"object age=${p.age}") // 合法,伴生对象可访问protected成员
  }
}
1.2.4 private [this] 对象私有权限
private[this]是 Scala 独有的访问权限,称为对象私有,是最严格的访问级别:
- 仅能在当前对象的内部访问,同一个类的其他对象实例也无法访问;
- 伴生对象也无法访问
private[this]修饰的成员; - Java 中无对应特性,体现了 Scala 更彻底的面向对象设计。
class Person0601 {
  // private[this]:仅当前对象内部可访问
  private[this] val password = "123456"

  // 本对象内部可访问
  println(s"internal password=${this.password}")

  def print(other: Person0601) = {
    // 合法,访问当前对象的password
    println(s"this password=${this.password}")
    // 非法,无法访问其他对象的private[this]成员
    // println(s"other password=${other.password}")
  }
}

object Person0601 {
  def main(args: Array[String]): Unit = {
    val p = new Person0601()
    // 非法,伴生对象也无法访问private[this]成员
    // println(s"object password=${p.password}")
    p.print(p)
  }
}
1.2.5 构造器参数的访问权限
Scala 主构造器的参数可直接添加访问控制符,控制参数的访问权限,对应课程源码Person0602.scala:
// 主构造器参数直接添加访问控制符
class Person0602(
                  protected val name: String,  // protected:子类可访问
                  private val age: Int,        // private:仅本类/伴生对象可访问
                  val city: String,             // 默认public:全局可访问
                  private[this] val weighs: Int // 对象私有:仅当前对象可访问
                )

class p0602 extends Person0602("yangmi", 30, "shanghai", 120) {
  // 合法,子类可访问protected的name
  println(s"protected name=${this.name}")
  // 非法,子类无法访问private的age
  // println(s"private age=${this.age}")
}

object Person0602 {
  def main(args: Array[String]): Unit = {
    val p = new Person0602("suyoupeng", 20, "beijing", 150)
    println(s"private age=${p.age}") // 合法,伴生对象可访问private成员
    // println(s"private weighs=${p.weighs}") // 非法,伴生对象无法访问private[this]成员
  }
}
1.3 包级作用域访问控制
Scala 支持通过private[包名]/protected[包名]实现包级别的作用域控制,可灵活指定成员在哪些包内可访问,对应课程源码Person0603.scala。
1.3.1 private [包名] 包私有
语法:private[包名] 成员,表示该成员仅能在本类、指定的包及其子包内访问,突破了 private 的限制,又比 public 更安全。
package scala06

class Person0603 {
  // private[scala06]:仅scala06包及其子包内可访问
  private[scala06] def print3(): Unit = {
    println("private[scala06]")
  }

  // private:仅本类/伴生对象可访问
  private def print1(): Unit = {
    println("private")
  }

  // private[this]:仅当前对象可访问
  private[this] def print2(): Unit = {
    println("private[this]")
  }
}

object Person0603 {
  def main(args: Array[String]): Unit = {
    val p3 = new Person0603()
    p3.print1() // 合法,伴生对象可访问private
    // p3.print2() // 非法,无法访问private[this]
    p3.print3() // 合法,同包内可访问private[scala06]
  }
}

// 嵌套包定义,演示跨包访问
package com.a.b.c {
  class Foo {
    private[c] def c(): Unit = println("c") // 仅c包内可访问
    private[b] def b(): Unit = println("b") // 仅b包及其子包可访问
    private[a] def a(): Unit = println("a") // 仅a包及其子包可访问
  }
}

// b包的子包c1,可访问private[b]和private[a]
package com.a.b.c1 {
  import com.a.b.c._
  class Bar {
    val f = new Foo()
    // f.c() // 非法,不在c包内
    f.b() // 合法,在b包的子包内
    f.a() // 合法,在a包的子包内
  }
}

// a包的子包b1,仅可访问private[a]
package com.a.b1 {
  import com.a.b.c._
  class Bar {
    val f = new Foo()
    // f.c() // 非法
    // f.b() // 非法,不在b包内
    f.a() // 合法,在a包的子包内
  }
}
1.3.2 protected [包名] 包保护
语法:protected[包名] 成员,表示该成员仅能在本类、子类、指定的包及其子包内访问,比private[包名]多了子类的访问权限。
第二章 Scala 包与导入
Scala 的包用于解决类的命名冲突、代码的模块化管理,与 Java 的包核心思想一致,但提供了更灵活的定义方式、更强大的导入特性,对应课程源码RunPackage.scala、RunImport.scala。
2.1 Scala 包的定义
Scala 提供两种包的定义方式,比 Java 更灵活,支持嵌套包定义与作用域控制。
2.1.1 方式 1:文件顶部声明(与 Java 一致)
在 Scala 文件的第一行通过package 包名声明包,文件内的所有类 / 对象都属于该包,与 Java 完全一致。
// 文件顶部声明包,与Java一致
package scala06

// 该类属于scala06包
class RunPackage {
  // 类内容
}
2.1.2 方式 2:花括号嵌套声明(Scala 独有)
通过package 包名 { }的方式嵌套定义包,可在同一个文件中定义多个包,精准控制包的作用域,这是 Scala 独有的特性。
// 嵌套定义com.acme.store包
package com.acme.store {
  class Foo0601 {
    override def toString = s"Foo0601() is com.acme.store.Foo0601"
  }
}

// 嵌套定义order包
package order {
  class Foo0601 {
    override def toString = s"Foo0601() is order.Foo0601"
  }

  // 嵌套子包order.customer
  package customer {
    class Foo0601 {
      override def toString = s"Foo0601() is order.customer.Foo0601"
    }
  }
}

object RunPackage {
  def main(args: Array[String]): Unit = {
    // 不同包的同名类,通过全限定名区分,解决命名冲突
    println(new com.acme.store.Foo0601().toString)
    println(new order.Foo0601().toString)
    println(new order.customer.Foo0601().toString)
  }
}
2.1.3 包的声明位置
Scala 的包声明不局限于文件顶部,可在代码的任意位置声明,而 Java 的包声明只能在文件的第一行(注释除外)。
2.2 Scala 包的导入特性
Scala 通过import关键字导入包 / 类,核心语法与 Java 一致,但提供了更强大、更灵活的导入特性,可在代码的任意位置使用 import 语句(Java 只能在文件顶部、类定义之前使用 import),对应课程源码RunImport.scala。
2.2.1 基础导入
// 导入单个类
import java.io.File
// 导入同一个包的多个类
import java.io.{File, BufferedWriter}
// 导入包内所有类(Scala用_,Java用*)
import java.nio._
注意:Scala 中导入包内所有类用通配符
_,而 Java 用*,因为 Scala 中*是合法的标识符(用于方法名、运算符)。
2.2.2 导入重命名(解决同名类冲突)
当导入不同包的同名类时,可通过import {原类名=>新别名}的方式给类重命名,解决命名冲突,这是 Scala 导入的核心特性之一。
// 导入Java的ArrayList,重命名为javaList
import java.util.{ArrayList => javaList}
// 导入Scala的List
import scala.collection.immutable.List

object PrintCollection {
  def main(args: Array[String]): Unit = {
    // 使用别名创建Java的ArrayList,避免与Scala的List冲突
    val javaArrayList = new javaList
    val scalaList = List(1,2,3)
  }
}
2.2.3 导入隐藏(排除指定类)
可通过import {类名=>_, _}的方式,导入包内除指定类之外的所有类,排除不需要的类,避免命名冲突。
// 导入java.util包内所有类,排除Random类
import java.util.{Random => _, _}

object Test {
  def main(args: Array[String]): Unit = {
    // 此时使用的Random是scala.util.Random,而非java.util.Random
    val r = new scala.util.Random()
  }
}
2.2.4 局部导入
Scala 的import语句可放在代码的任意位置,包括方法内部、代码块内部,称为局部导入,导入的类仅在当前作用域内有效,避免全局命名污染。
object RunImport {
  def main(args: Array[String]): Unit = {
    // 方法内部局部导入,仅在main方法内有效
    import scala.util.Random
    val r = new Random()
    println(s"RunImport=${r.nextInt(10)}")
  }
}
2.3 包对象 package object
这是一个非常有特色的功能。如果你想让整个包共享一些常量或方法,Java 通常需要建一个 Constants 类,而 Scala 使用 Package Object。
包对象是 Scala 的特殊特性,用于在包级别定义全局的函数、变量、常量,解决了 Java 中只能在类中定义静态成员的限制。
- 每个包只能有一个包对象,包对象必须与包同名,定义在
package.scala文件中; - 包对象中定义的成员,在该包内可直接访问,无需通过类名调用;
- 对应作业中的问题:Scala 设计者提供 package object,而非直接在包中添加函数 / 变量,是因为 JVM 的包本身不能包含成员,只能通过包对象这种语法糖,在 JVM 的规则内实现包级别的全局成员。
包对象定义示例
// 文件名必须为package.scala
package cn.scala

// 包对象,与包cn.scala同名
package object Utils {
  // 包级别的全局函数
  def toString(x: String): Unit = {
    println(s"Utils=$x")
  }

  // 包级别的全局常量
  val DEFAULT_VERSION = "2.12.18"
}

// 包内的类,可直接访问包对象的成员
package person {
  class Teacher(var name: String) {
    def printName(): Unit = {
      // 直接调用包对象的函数,无需导入
      toString(name)
    }
  }
}

// 测试
object packageDemo {
  def main(args: Array[String]): Unit = {
    // 外部包访问,通过全限定名调用
    cn.scala.Utils.toString("scala")
    new cn.scala.person.Teacher("teacher").printName()
  }
}
💡 总结与对比
| 特性 | Java | Scala |
|---|---|---|
| 位置 | 必须在文件顶部 | 随处可见(局部作用域) |
| 通配符 | * | _ |
| 重命名 | 不支持 | 支持 (=>) |
| 静态导入 | import static | 直接 import Object._ |
| 包共享 | 只能通过静态类 | Package Object |
在实际开发中,如果你不确定用什么,就保持默认(Public)。如果你在写工具库,希望某些方法只对当前包内的代码开放,那么 private[yourPackage] 是最优雅的选择。
第三章 Scala 集合体系
Scala 集合是 Spark/Flink 大数据开发的核心基础,Spark RDD 的所有算子设计都完全对标 Scala 集合的高阶函数,掌握 Scala 集合是学习 Spark 的前提。
3.1 Scala 集合整体概述
3.1.1 与 Java 集合的核心差异
- 体系整合:Java 中
Map是独立的体系,不继承自Collection;Scala 中Map、Set、Seq都继承自统一的Iterable特质,属于同一个集合体系; - 可变与不可变双分支:Scala 集合分为不可变集合和可变集合两大分支,Java 集合仅提供可变集合,不可变集合需第三方库实现;
- 函数式编程支持:Scala 所有集合都内置了
map、flatMap、filter、reduce等高阶函数,Java8 之前无 Lambda 支持,集合操作繁琐; - 默认不可变:Scala 默认使用不可变集合,无需手动声明,而 Java 默认是可变集合。
3.1.2 集合的三大顶级包
Scala 所有集合都来自三个包,核心分为不可变和可变两大分支:
| 包名 | 特性 | 说明 |
|---|---|---|
scala.collection.immutable | 不可变集合 | 集合一旦创建,内容永远不可修改;修改操作会返回一个全新的集合,原集合保持不变;Scala 默认导入,是默认使用的集合 |
scala.collection.mutable | 可变集合 | 集合创建后,可在原集合上修改内容,不会生成新集合;需手动导入使用 |
scala.collection | 通用集合 | 包含了可变和不可变集合的通用特质 / 抽象类,定义了集合的通用规范 |
大数据场景核心原则:优先使用不可变集合,不可变集合线程安全,无副作用,完美适配 Spark 的分布式不可变 RDD 模型,避免并发修改带来的问题。
3.2 集合的核心继承层级
Scala 集合的顶级父特质是Iterable(可迭代),所有集合都继承自该特质,核心分为三大分支:Seq、Set、Map。
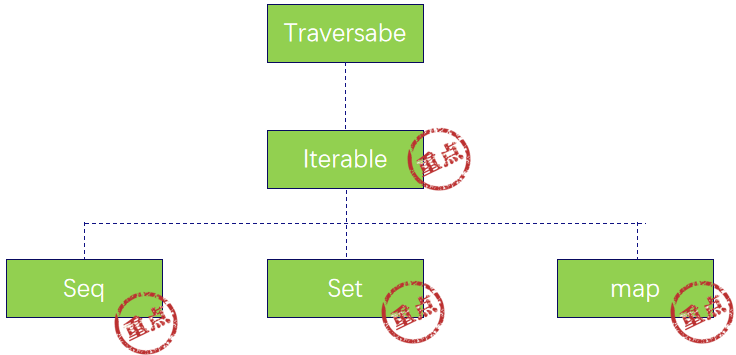
Iterable(所有可迭代集合的顶级父特质)
├─ Seq(有序、可重复的序列,对应Java的List)
│  ├─ IndexedSeq(索引序列,支持随机访问,如Vector、Array)
│  └─ LinearSeq(线性序列,支持顺序访问,如List、LazyList)
├─ Set(无序、不可重复的集合,与Java的Set一致)
│  ├─ SortedSet(排序集合,如TreeSet)
│  └─ HashSet(哈希集合)
└─ Map(键值对映射,与Java的Map一致)
   ├─ SortedMap(排序映射,如TreeMap)
   └─ HashMap(哈希映射)
3.2.1 Seq 序列
核心特性:元素有序、可重复,每个元素都有对应的索引(从 0 开始);
常用实现类:
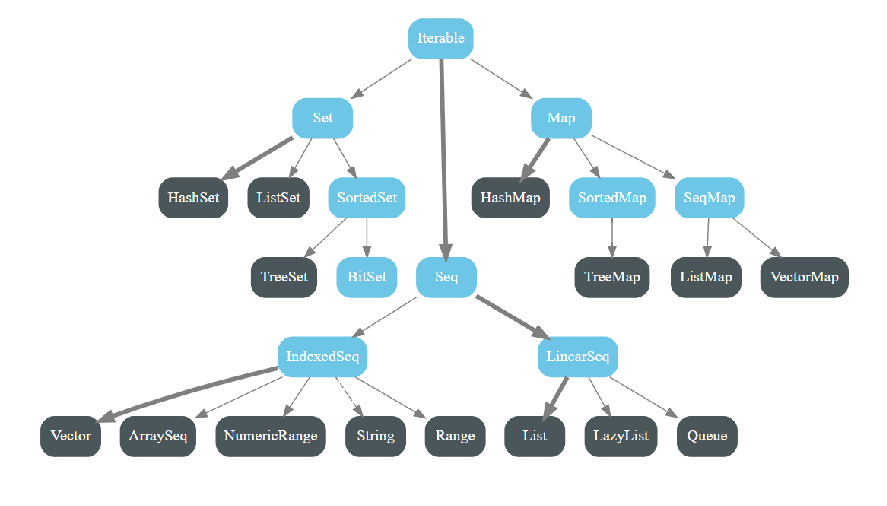
- 不可变:
List、Vector、Range、String(Scala 中 String 可直接当作 Char 序列); - 可变:
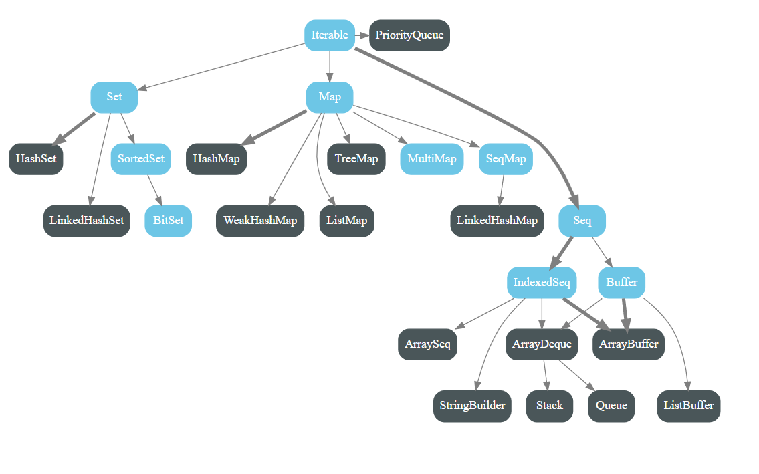
ArrayBuffer、ListBuffer、StringBuilder、Queue、Stack。
- 不可变:
3.2.2 Set 集合
核心特性:元素无序、不可重复,自动去重;
常用实现类:
- 不可变:
HashSet、TreeSet、BitSet; - 可变:
HashSet、LinkedHashSet、SortedSet。
- 不可变:
3.2.3 Map 映射
核心特性:键值对 (KV) 存储,键不可重复,值可重复;
常用实现类:
- 不可变:
HashMap、TreeMap、ListMap; - 可变:
HashMap、LinkedHashMap、TreeMap、MultiMap。
- 不可变:
scala.collection
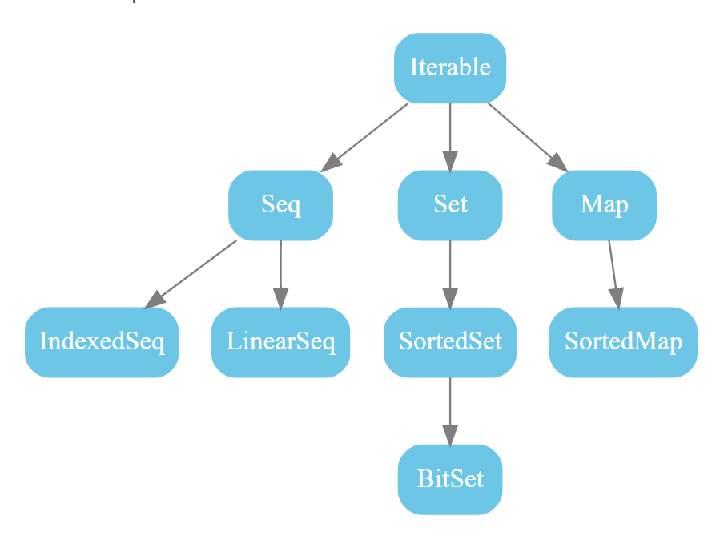
scala.collection.mutable
scala.collection.immutable
Scala的集合的一致性
在 Scala 中,集合的**一致性(Consistency/Uniformity)**是一个非常高级且优雅的设计理念。它确保了无论你使用哪种集合(List, Set, Map),它们的操作逻辑、返回类型以及在可变/不可变之间的转换都遵循一套统一的原则。
1. 层次结构的一致性 (Hierarchy)
Scala 的集合框架分为三个主要层级:Seq(序列)、Set(集)和 Map(映射)。
- 统一根接口:所有的集合都继承自
Iterable。这意味着无论什么集合,你都可以使用foreach、iterator或for-yield进行遍历。 - 镜像包结构:Scala 同时提供了
scala.collection.immutable(默认)和scala.collection.mutable。这两个包的结构几乎是镜像对称的。- 例如:你在不可变包里有
Map,在可变包里也有一个对应的Map,它们拥有大部分相同的方法名。
- 例如:你在不可变包里有
2. 操作方法的一致性 (Uniform Operations)
这是 Scala 最强大的地方。无论你面对的是哪种集合,处理数据的方法几乎是完全通用的。
核心方法三剑客:
- 转化操作:
map,flatMap,collect - 过滤操作:
filter,take,drop,distinct - 聚合操作:
reduce,fold,sum,count
val list = List(1, 2, 3)
val set = Set(1, 2, 3)
val map = Map(1 -> "one", 2 -> "two")

// 无论什么容器,用法完全一致
list.map(_ * 2)
set.map(_ * 2)
map.map { case (k, v) => (k, v.toUpperCase) }
3. 返回类型的一致性 (Same-Result-Type Principle)
Scala 遵循一个重要原则:对某种集合进行转换操作,返回的依然是同类型的集合。
- 如果你对
List进行filter,结果一定是List。 - 如果你对
Set进行map,结果一定是Set(且会自动去重)。 - 如果你对
BitSet(位集)进行操作,结果依然是BitSet。
这种一致性是通过底层复杂的 CanBuildFrom(Scala 2.12以前)或 BuildFrom(Scala 2.13+)机制实现的,它保证了类型信息的最高精确度。
4. 转换的一致性 (Conversion)
在可变(Mutable)与不可变(Immutable)之间切换,或者在不同容器间切换,Scala 提供了高度一致的 API:
val immList = List(1, 2, 3)

// 转换到可变版本
val mutList = immList.toBuffer

// 在不同类型间无缝转换
val set = immList.toSet
val array = immList.toArray
val immutableList = mutList.toList
5. 性能特征的一致性 (Performance Characteristics)
Scala 官方文档为所有集合提供了一致的性能指标表(Time Complexity)。开发者可以预知:
List的头部操作始终是 $O(1)$,随机访问是 $O(n)$。Vector的所有操作几乎都是“近似 $O(1)$”($O(log_{32}n)$)。
这种性能表现的一致性使得在编写高性能代码时,选择合适的集合变得非常直观。
3.3 不可变集合与可变集合实战
对应课程源码RunColletion.scala,演示不可变集合与可变集合的核心差异,以及数字拆解去重的实战案例。
3.3.1 不可变集合
不可变集合的修改操作,不会改变原集合,只会返回一个新的集合,原集合永远保持不变,线程安全,无副作用。
object RunColletion {
  def main(args: Array[String]): Unit = {
    // 不可变Set,默认使用immutable.Set
    val c1 = Set(1)
    // +操作返回新的Set,原集合c1保持不变
    val c2 = c1 + 3
    println(s"c1=${c1},c2=${c2}") // 输出:c1=Set(1),c2=Set(1,3)

    // 不可变Vector
    var v1 = Vector("v1")
    // v1(0) = "v2" // 非法,不可变集合无法修改元素
  }
}
3.3.2 可变集合
可变集合的修改操作,直接在原集合上进行,不会生成新的集合,性能更高,但非线程安全,需手动控制并发。
object RunColletion {
  def main(args: Array[String]): Unit = {
    // 导入可变Set
    val mutableset = scala.collection.mutable.Set(5)
    // add方法直接修改原集合,返回是否添加成功
    mutableset.add(3)
    println(s"mutableset=${mutableset}") // 输出:mutableset=Set(3,5)
  }
}
3.3.3 实战案例:数字拆解去重
课程案例:编写方法,将一个整数的每一位数字拆解,放入 Set 中自动去重,返回无重复的数字集合。
object RunColletion {
  def main(args: Array[String]): Unit = {
    val reslut = dig(1234576311)
    println(reslut) // 输出:Set(1,2,3,4,5,6,7)
  }

  // 递归拆解数字,返回无重复的数字集合
  def dig(n: Int): Set[Int] = {
    if (n < 0) dig(-n) // 处理负数
    else if (n < 10) Set(n) // 个位数,直接返回单元素Set
    else dig(n / 10) + (n % 10) // 递归拆解高位,加上当前个位数字
  }
}
第四章 Scala 迭代器
Scala 迭代器Iterator不是一个集合,而是一种访问集合的方法,提供了逐个遍历集合元素的能力,核心价值在于懒加载、不一次性加载所有数据到内存,是大数据海量数据处理的核心工具。
大数据场景应用:处理超大文件、海量数据集时,直接用集合会一次性加载所有数据到内存,导致 OOM 内存溢出;而迭代器是逐条读取数据,内存中仅保留当前元素,完美解决海量数据的遍历问题,Spark 的分区数据遍历底层就是基于迭代器实现。
4.1 迭代器的核心特性
一次性遍历:迭代器遍历完成后,指针会移动到末尾,无法重复遍历,再次调用
next()会抛出异常;懒加载:迭代器不会提前加载所有元素,只有调用
next()时才会加载下一个元素,内存占用极低;两个核心抽象方法:
hasNext():判断是否还有下一个元素,返回 Boolean;next():获取下一个元素,指针向后移动一位。
4.2 迭代器的基础使用
对应课程源码RunIterator.scala,演示迭代器的创建、遍历与核心特性。
4.2.1 迭代器的创建
object RunIterator {
  def main(args: Array[String]): Unit = {
    // 方式1:直接创建迭代器,传入多个元素
    val it2 = Iterator(1, 2, 3)
    // 方式2:将Range转为迭代器,_*表示将Range展开为可变参数
    val it3 = Iterator(1 to 5: _*)
  }
}
4.2.2 迭代器的遍历
Scala 提供两种遍历迭代器的方式:while循环(最常用)和for循环。
object RunIterator {
  def main(args: Array[String]): Unit = {
    val it3 = Iterator(1 to 5: _*)

    // 方式1:while循环遍历(推荐,大数据场景最常用)
    while (it3.hasNext) {
      println(it3.next())
    }

    // 方式2:for循环遍历
    val it4 = Iterator(1 to 3: _*)
    for (i <- it4) {
      println(s"i=$i")
    }

    // 核心特性:迭代器遍历一次后失效,无法重复遍历
    // 第二次遍历it4,无任何输出,因为指针已到末尾
    it4.foreach(x => println(x))
  }
}
4.3 迭代器的常用方法
对应课程源码RunIterator.scala,演示迭代器的高频常用方法,这些方法与集合的高阶函数用法一致,且保持懒加载特性。
4.3.1 duplicate 复制迭代器
duplicate方法会生成两个完全相同的新迭代器,可分别独立遍历,解决迭代器无法重复遍历的问题。
object RunIterator {
  def main(args: Array[String]): Unit = {
    val it5 = Iterator(6 to 8: _*)
    // 复制为两个独立的迭代器
    val (it51, it52) = it5.duplicate

    // 遍历第一个迭代器
    it51.foreach(x => println(x)) // 输出6、7、8
    // 遍历第二个迭代器,不受第一个影响
    it52.foreach(x => println(x)) // 输出6、7、8
  }
}
4.3.2 take 取前 n 个元素
take(n)方法返回一个包含前 n 个元素的新迭代器,原迭代器的指针会移动 n 位。
object RunIterator {
  def main(args: Array[String]): Unit = {
    val it6 = Iterator(9 to 12: _*)
    // 取前2个元素
    val it61 = it6.take(2)
    it61.foreach(x => println("it61=" + x)) // 输出9、10
    // 原迭代器剩余元素:11、12
    it6.foreach(x => println("it6=" + x)) // 输出11、12
  }
}
4.3.3 slice 切片
slice(from, to)方法返回一个从 from 索引开始、到 to 索引结束(不包含 to)的新迭代器,用于截取迭代器的指定区间。
object RunIterator {
  def main(args: Array[String]): Unit = {
    val it7 = Iterator(13 to 18: _*)
    // 截取索引1到10的元素,实际只有13(0)、14(1)~18(5)
    val it71 = it7.slice(1, 10)
    it71.foreach(x => println("it71=" + x)) // 输出14、15、16、17、18
  }
}
4.3.4 zip/zipAll 拉链
zip方法将两个迭代器的元素配对,生成键值对迭代器,以最短的迭代器为准;zipAll可指定默认值,补齐长度不一致的情况。
object RunIterator {
  def main(args: Array[String]): Unit = {
    val it8k2 = Iterator("k1") // 键迭代器,1个元素
    val it8v1 = Iterator("v1", "v2") // 值迭代器,2个元素

    // zipAll:指定键的默认值default1,值的默认值default2
    val k2_v1 = it8k2.zipAll(it8v1, "default1", "default2")
    k2_v1.foreach(x => println(x))
    // 输出:
    // (k1,v1)
    // (default1,v2)
  }
}
第五章 课后作业全解析
对应课程配套作业文档,包含简答题与编程题全解析,所有代码可直接复制运行。
一、简答题
(1)Scala 有哪些控制符?
答:Scala 提供了 6 种访问控制符,按权限从大到小排序如下,同时明确了各控制符的作用域:
- 无修饰符(默认访问权限):等同于 Java 的
public,全局任何位置均可访问,Scala 无public关键字,无修饰符即为默认公开权限。 - protected [包名]:包级保护权限,本类、子类、指定包及其子包内均可访问。
- private [包名]:包级私有权限,本类、指定包及其子包内均可访问,子类无访问权限。
- protected:仅本类、子类、伴生对象可访问,同包内其他类无法访问,比 Java 的
protected权限更严格。 - private:仅本类及其伴生对象可访问,子类、外部类均无法访问,与 Java 的核心差异是允许伴生对象访问。
- private[this]:对象级私有,Scala 独有的最严格权限,仅当前对象内部可访问,同一个类的其他对象、伴生对象均无法访问。
(2)Scala 包都可以在哪些位置声明,有哪些访问权限?
答:
1. Scala 包的声明位置
Scala 包的声明比 Java 灵活,支持两个位置声明:
- 文件顶部声明:与 Java 一致,在 Scala 文件的第一行(注释除外)通过
package 包名声明,文件内所有类 / 对象都属于该包; - 代码任意位置嵌套声明:Scala 独有特性,通过
package 包名 { }的花括号语法,可在代码的任意位置嵌套声明包,支持多层子包嵌套,同一个文件中可定义多个不同的包。
2. Scala 包的访问权限控制
Scala 通过包级访问控制符,精准控制成员在包内的访问权限,核心有两种:
- private [包名]:包级私有,成员仅能在本类、指定的包及其子包内访问,其他包无法访问;
- protected [包名]:包级保护,成员仅能在本类、子类、指定的包及其子包内访问,比 private [包名] 多了子类的访问权限;
- 无修饰符的成员,在所有包内均可访问;private/protected 无包名限定的成员,仅能在本类 / 子类中访问,跨包无法访问。
(3)在你看来 Scala 的设计者为什么要提供 package object 语法而不是简单地让你将函数和变量添加到包中呢?
答:核心原因是Scala 需要兼容 JVM 的底层规范,同时实现包级别的全局函数 / 变量,具体分析如下:
- JVM 的底层限制:JVM 的虚拟机规范中,包本身是一个命名空间,不能包含任何成员(函数、变量、常量),所有的成员必须定义在类 / 接口中。Java 中只能通过类的静态成员实现类似全局的功能,无法直接在包中添加函数和变量。
- package object 的语法糖作用:Scala 的 package object 是 JVM 规范之上的语法糖,编译器会将包对象编译为一个特殊的类,包对象中定义的函数 / 变量会被编译为该类的静态成员,从而在 JVM 规则内实现了包级别的全局成员。
- 简化代码,提升开发效率:在包对象中定义的函数 / 变量,在该包内可直接访问,无需通过类名调用,避免了 Java 中必须通过
工具类名.方法名的繁琐写法,更符合函数式编程的习惯。 - 统一包级别的工具方法 / 常量:package object 为整个包提供了统一的全局工具方法、常量、类型别名,无需在每个类中重复定义,实现了包级别的代码复用。
二、编程题
(1)编写一个包 random,加入函数:nextInt ():Int,nextDouble ():Double,setSeed (seed:Int):Unit。生成随机数的算法采用线性同余生成器:后值 = (前值 * a + b) mod 2^n,其中,a = 1664525,b=1013904223,n = 32,前值的初始值为 seed。
// 文件名:package.scala,必须放在random包对应的目录下
package com.scala

// 包对象random
package object random {
  // 算法常量
  private val a: Long = 1664525L
  private val b: Long = 1013904223L
  private val n: Int = 32
  // 2的n次方,用于取模
  private val modValue: Long = 1L << n // 2^32

  // 种子,初始值可通过setSeed设置
  private var seed: Long = 1L

  /**
   * 设置随机数种子
   * @param seed 初始种子
   */
  def setSeed(seed: Int): Unit = {
    this.seed = seed.toLong
  }

  /**
   * 生成下一个随机Int值
   * @return 随机Int整数
   */
  def nextInt(): Int = {
    // 线性同余公式计算下一个种子
    seed = (seed * a + b) % modValue
    // 转为Int返回
    seed.toInt
  }

  /**
   * 生成下一个随机Double值,范围[0.0, 1.0)
   * @return 随机Double小数
   */
  def nextDouble(): Double = {
    // 先获取随机Int,转为0~2^32之间的无符号数,再除以2^32,得到0~1之间的小数
    val next = nextInt().toLong & 0xFFFFFFFFL // 转为无符号32位整数
    next.toDouble / modValue.toDouble
  }
}

// 测试类
object RandomTest {
  def main(args: Array[String]): Unit = {
    // 导入random包的所有函数
    import com.scala.random._

    // 设置种子
    setSeed(123456)
    println("===== 随机Int =====")
    for (_ <- 1 to 5) {
      println(nextInt())
    }

    println("\n===== 随机Double =====")
    for (_ <- 1 to 5) {
      println(nextDouble())
    }

    // 重新设置种子,验证可复现
    println("\n===== 重置种子后 =====")
    setSeed(123456)
    println(nextInt()) // 与第一次的第一个Int值一致
  }
}
(2)编写一段程序,将 Java 哈希映射中的所有元素拷贝到 Scala 哈希映射。用引入语句重命名这两个类。
import java.util.{HashMap => JavaHashMap} // Java HashMap重命名为JavaHashMap
import scala.collection.mutable.{HashMap => ScalaHashMap} // Scala可变HashMap重命名为ScalaHashMap

object HashMapCopy {
  def main(args: Array[String]): Unit = {
    // 1. 创建Java的HashMap,并添加元素
    val javaMap = new JavaHashMap
    javaMap.put("java", 1)
    javaMap.put("scala", 2)
    javaMap.put("spark", 3)
    javaMap.put("flink", 4)
    println(s"Java HashMap: $javaMap")

    // 2. 创建Scala的HashMap
    val scalaMap = new ScalaHashMap

    // 3. 遍历Java HashMap,拷贝所有元素到Scala HashMap
    // 方式1:迭代器遍历
    val entryIterator = javaMap.entrySet().iterator()
    while (entryIterator.hasNext) {
      val entry = entryIterator.next()
      scalaMap.put(entry.getKey, entry.getValue)
    }

    // 方式2:Scala函数式写法(更简洁)
    // import scala.collection.JavaConverters._
    // javaMap.asScala.foreach { case (k, v) => scalaMap.put(k, v) }

    // 4. 打印结果,验证拷贝完成
    println(s"Scala HashMap: $scalaMap")
  }
}
学习总结
- Scala 访问权限:Scala 提供了比 Java 更精细的访问控制,核心是取消了
public关键字,新增了private[this]对象私有和private[包名]包级私有,实现了更灵活的封装控制,编写 Scala 代码时应遵循最小权限原则,优先使用严格的访问控制符。 - Scala 包与导入:Scala 支持嵌套包定义、任意位置导入、导入重命名、导入隐藏等高级特性,完美解决了不同包同名类的冲突问题;包对象
package object实现了包级别的全局成员,是 Scala 对 JVM 规范的优雅扩展。 - Scala 集合体系:Scala 集合分为不可变和可变两大分支,默认使用不可变集合,线程安全、无副作用,完美适配 Spark 的分布式不可变 RDD 模型;集合分为
Seq、Set、Map三大分支,内置了丰富的高阶函数,是函数式编程的核心载体。 - Scala 迭代器:迭代器不是集合,而是访问集合的工具,核心特性是懒加载、一次性遍历、低内存占用,是大数据场景下处理海量数据、超大文件的核心工具,避免了一次性加载数据导致的 OOM 内存溢出,Spark 分区数据的底层遍历完全基于迭代器实现。
- 大数据开发适配:本节内容是 Spark 开发的前置核心基础,Spark RDD 的算子设计完全对标 Scala 集合的高阶函数,RDD 的不可变特性与 Scala 不可变集合完全一致,掌握本节内容,后续学习 Spark 会事半功倍。
下一章预习内容:Scala 常见集合操作。