8 Set、Map 集合与模式匹配
笔记衔接前序《Scala Seq 序列集合》,严格匹配课程体系,针对有 Java 基础的大数据专业大学生设计,全程Java 语法对比 + 课程配套源码拆解 + Spark 大数据场景应用 + 避坑指南 + 作业全解析。Set、Map 是 Scala 最核心的键值 / 去重集合,模式匹配是 Scala 最具特色的语法特性,三者是 Spark/Flink 大数据开发的核心基础,Spark PairRDD 的算子设计完全对标 Map 操作,模式匹配更是 Spark 源码中随处可见的核心语法。
前置知识:Scala 集合体系、Seq 序列、面向对象基础、函数式编程
开发环境:JDK1.8+、Scala2.12.x、IDEA + Scala 插件
核心学习目标:
- 掌握 Scala Set 集合的核心特性、常用操作与特殊实现类,明确可变与不可变 Set 的适用场景
- 熟练掌握 Scala Map 映射的增删改查、过滤排序等全量操作,理解与 Java HashMap 的核心差异
- 掌握 Scala 各类集合的性能特性,能够根据大数据业务场景选择最优的集合类型
- 深入理解 Scala 模式匹配的核心思想,熟练掌握 8 种常用模式匹配类型,能够灵活应用于业务开发
- 独立完成课程配套作业,掌握 Map 索引构建、二叉树递归求和等实战技巧
第一章 Scala Set 集合
Set 是无序、元素不可重复的集合,核心作用是元素去重、快速判重,与 Java 的 Set 接口核心思想一致,但 Scala 同样提供了不可变和可变两大分支,默认使用不可变 Set。
1.1 Set 核心概述
1.1.1 核心特性
- 元素唯一性:Set 会自动对元素去重,重复添加相同元素不会生效;
- 无序性:默认 HashSet 不保证元素的存储顺序,SortedSet 可实现有序;
- 两大分支:默认使用
scala.collection.immutable.Set,可变 Set 需手动导入scala.collection.mutable.Set; - 高效判重:基于哈希表实现的 Set,
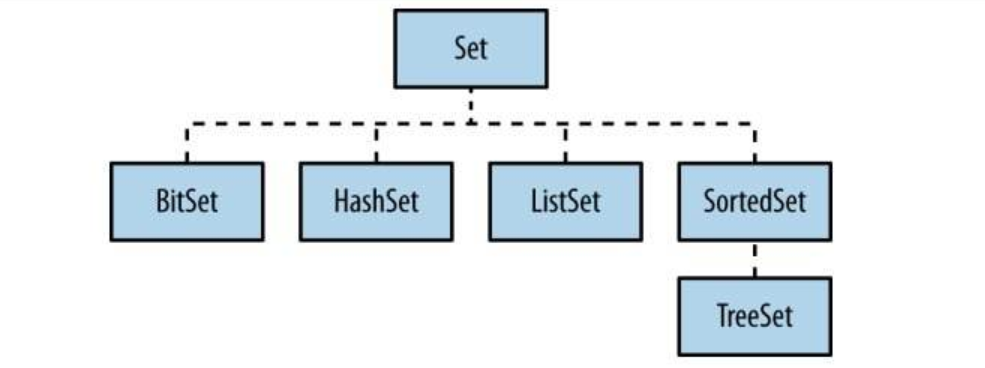
contains方法时间复杂度为 O (1),远优于 Seq 的 O (n),大数据场景下判重 / 去重优先使用 Set。 - Scala的Set继承关系
1.1.2 与 Java Set 的核心差异
| 特性 | Scala Set | Java Set |
|---|---|---|
| 默认类型 | 不可变 Set,线程安全 | 可变 HashSet,非线程安全 |
| 语法简洁性 | 支持Set(1,2,3)直接创建,支持set(元素)直接判重 | 需new HashSet<>()创建,判重需调用contains()方法 |
| 不可变支持 | 原生提供不可变实现,修改操作返回新集合 | 需通过Collections.unmodifiableSet()包装,修改会抛出异常 |
| 函数式支持 | 内置 map/filter/reduce 等高阶函数 | Java8 前无 Lambda 支持,需循环实现 |
1.2 Set 核心常用操作
对应课程配套源码RunSet.scala,分为不可变 Set 与可变 Set 两大类操作。
1.2.1 基础判重与子集判断
import scala.collection.mutable

object RunSet {
  def main(args: Array[String]): Unit = {
    // 1. 创建Set,自动去重
    val s1 = Set(1,2,3,3,2,5)
    println(s1) // 输出:Set(1,2,3,5),自动去重

    // 2. 元素判重,两种写法等价
    println(s1.contains(1), s1.contains(6)) // 输出:(true,false)
    println(s1(2), s1(8)) // 输出:(true,false),Scala特有简洁写法

    // 3. 子集判断subsetOf
    val s2 = Set(3,5)
    val s3 = Set(4,5)
    println(s"s2 是 s1 的子集:${s2.subsetOf(s1)}") // 输出:true
    println(s"s3 是 s1 的子集:${s3.subsetOf(s1)}") // 输出:false
  }
}
1.2.2 不可变 Set 的增删操作
不可变 Set 的增删操作不会修改原集合,只会返回一个全新的 Set,原集合保持不变。
object RunSet {
  def main(args: Array[String]): Unit = {
    // 不可变Set
    var imms = Set(4,5,6)
    // 加单个元素,返回新Set
    val imm1 = imms + 3
    // 加多个元素
    val imm2 = imm1 + (22,33)
    // 加整个集合
    val imm3 = imm2 ++ List(44,55)
    // 删除单个元素
    val imm4 = imm3 - 22
    // 删除多个元素
    val imm5 = imm4 -- List(33,44)

    println(imm5) // 输出:Set(4,5,6,3,55)
    println(imms) // 原集合不变,输出:Set(4,5,6)
  }
}
1.2.3 可变 Set 的增删操作
可变 Set 的增删操作直接修改原集合,无返回值(或返回是否操作成功),性能更高,适合局部高频增删场景。
import scala.collection.mutable

object RunSet {
  def main(args: Array[String]): Unit = {
    // 创建可变Set
    var ms = mutable.Set(7,8,9)
    // 1. 添加元素
    ms += 10 // 加单个元素
    ms += (11,12,12) // 加多个元素,重复元素自动忽略
    ms ++= Set(13,14) // 加整个集合
    println(ms) // 输出:Set(9,13,14,12,7,8,10,11)

    // 2. 条件删除:保留满足条件的元素,删除不满足的
    ms.retain(_ > 9)
    println(ms) // 输出:Set(13,14,12,10,11)

    // 3. 删除元素
    ms.remove(12) // 删除指定元素,返回是否删除成功
    ms -= 10 // 单个删除
    ms --= List(11,13) // 批量删除
    println(ms) // 输出:Set(14)

    // 4. 清空集合
    ms.clear()
    println(ms) // 输出:Set()
  }
}
1.2.4 集合二元操作(交、并、差)
| 操作 | 方法 | 说明 | |
|---|---|---|---|
| 并集 | set1 ++ set2 / `set1 | set2` | 两个集合的所有元素,自动去重 |
| 交集 | set1 & set2 / set1.intersect(set2) | 两个集合都包含的元素 | |
| 差集 | set1 -- set2 / set1 &~ set2 | set1 中包含、set2 中不包含的元素 |
1.3 Set 特殊实现类
Scala 提供了多种 Set 的特殊实现类,适配不同的业务场景,课程中重点讲解了 SortedSet 和 LinkedHashSet。
1.3.1 SortedSet(排序 Set)
SortedSet 会自动对元素进行排序,分为不可变SortedSet和可变mutable.SortedSet,默认实现是TreeSet,基于红黑树实现。
- 基础类型(Int、String 等)可直接排序,Scala 已提供默认排序规则;
- 自定义类型必须实现
Ordered特质,重写compare方法定义排序规则。
import scala.collection.immutable.SortedSet
import scala.collection.mutable

object RunSet {
  def main(args: Array[String]): Unit = {
    // 1. 基础类型排序Set
    val ss1 = mutable.SortedSet(10,3,11,2)
    val ss3 = SortedSet(7,3,11)
    println(ss1) // 输出:TreeSet(2, 3, 10, 11),自动升序
    println(ss3) // 输出:TreeSet(3,7,11)

    // 字符串按字典序排序
    val ss2 = mutable.SortedSet("banana","apple","orange")
    println(ss2) // 输出:TreeSet(apple, banana, orange)

    // 2. 自定义类型排序,实现Ordered特质
    class Person0701(var name:String, var age:Int) extends Ordered[Person0701] {
      // 重写compare方法,按年龄降序排序
      override def compare(that: Person0701): Int = {
        if(this.age == that.age) 0
        else if (this.age < that.age) 1
        else -1
      }
      override def toString = s"Person0701($name, $age)"
    }

    // 自定义类型的SortedSet
    val p1 = new Person0701("scala",12)
    val p2 = new Person0701("java",2)
    val p3 = new Person0701("c",20)
    val pSet = mutable.SortedSet(p1,p2,p3)
    println(pSet) // 按年龄降序输出:TreeSet(Person0701(c, 20), Person0701(scala, 12), Person0701(java, 2))
  }
}
1.3.2 LinkedHashSet(插入有序 Set)
mutable.LinkedHashSet会保留元素的插入顺序,基于哈希表 + 双向链表实现,兼顾了 O (1) 的判重效率和插入有序的特性。
import scala.collection.mutable

object RunSet {
  def main(args: Array[String]): Unit = {
    val lhs = mutable.LinkedHashSet(1,8,4,2,8)
    println(lhs) // 输出:LinkedHashSet(1, 8, 4, 2),保留插入顺序,自动去重
  }
}
第二章 Scala Map 映射集合
Map 是键值对 (KV) 形式的集合,每个键对应唯一的值,键不可重复,值可重复,对应 Java 的 Map 接口,是 Scala 最常用的集合之一,Spark PairRDD 的所有算子都对标 Map 的操作逻辑。
2.1 Map 核心概述
2.1.1 核心特性
- KV 结构:每个元素都是
(键, 值)的元组,或用键->值的形式表示; - 键唯一性:键不可重复,重复添加相同的键会覆盖原有值;
- 两大分支:默认使用
scala.collection.immutable.Map,可变 Map 需手动导入scala.collection.mutable.Map; - 高效查询:基于哈希表实现的 Map,按键查询的时间复杂度为 O (1),是大数据场景下索引构建、数据关联的核心工具。
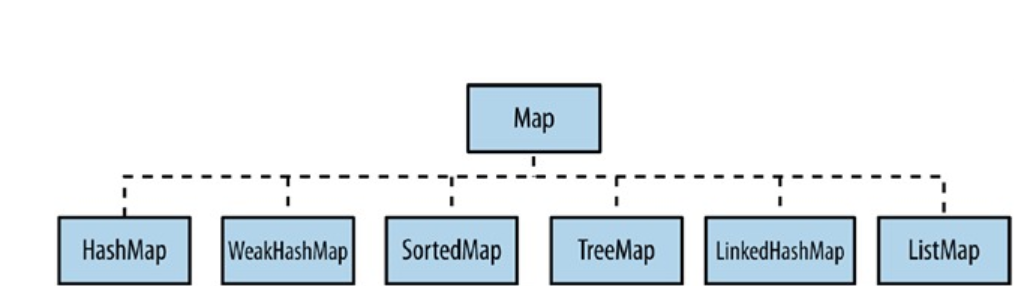
- Scala的map继承关系
2.1.2 Map 的两种创建方式
Scala 提供两种创建 Map 的方式,语义完全一致,可根据习惯选择:
// 方式1:使用 -> 符号创建,最常用
val map1 = Map("scala1"->1, "scala2"->2)
// 方式2:使用元组创建
val map2 = Map(("scala1",1), ("scala2",2))
2.1.3 与 Java Map 的核心差异
| 特性 | Scala Map | Java Map |
|---|---|---|
| 默认类型 | 不可变 Map,线程安全 | 可变 HashMap,非线程安全 |
| 语法简洁性 | 支持Map(k->v)直接创建,支持map(key)直接取值 | 需new HashMap<>()创建,取值需调用get(key) |
| 不可变支持 | 原生提供不可变实现,修改操作返回新 Map | 需通过Collections.unmodifiableMap()包装,修改会抛出异常 |
| 函数式支持 | 内置 map/filter/flatMap 等高阶函数,支持按键 / 值过滤排序 | Java8 前无 Lambda 支持,操作繁琐 |
| 空值处理 | 提供getOrElse、Option类型,从根源避免空指针异常 | 取值为 null 时直接抛出空指针异常,需手动判空 |
2.2 不可变 Map 常用操作
不可变 Map 一旦创建,键值对无法修改,所有增删改操作都会返回一个全新的 Map,原 Map 保持不变,对应课程源码RunMap.scala。
2.2.1 基础查询操作
object RunMap {
  def main(args: Array[String]): Unit = {
    // 创建不可变Map
    val m1 = Map("scala1"->1, "scala2"->2)

    // 1. 直接取值:键不存在会抛出NoSuchElementException
    val v1 = m1("scala1")
    println(s"v1=$v1") // 输出:v1=1
    // val v2 = m1("scala3") // 键不存在,抛出异常

    // 2. 安全取值:get方法返回Option类型,键不存在返回None,避免空指针
    val v3 = m1.get("scala1")
    val v4 = m1.get("scala4")
    println(s"v3=$v3, v4=$v4") // 输出:v3=Some(1), v4=None

    // 3. 带默认值的安全取值:键不存在返回指定默认值
    val v5 = m1.getOrElse("scala5", "default")
    println(s"v5=$v5") // 输出:v5=default

    // 4. 判断键是否存在
    if(m1.contains("scala2")) {
      println("find " + m1.get("scala2")) // 输出:find Some(2)
    } else {
      println("un find ")
    }
  }
}
2.2.2 增删改操作
object RunMap {
  def main(args: Array[String]): Unit = {
    val m1 = Map("scala1"->1, "scala2"->2)

    // 1. 添加键值对,返回新Map
    val m2 = m1 + ("scala3"->3)
    val m3 = m2 + ("scala4"->4, "scala5"->5) // 批量添加
    println(s"m3=$m3") // 输出:m3=Map(scala1 -> 1, scala2 -> 2, scala3 -> 3, scala4 -> 4, scala5 -> 5)

    // 2. 更新键值对:相同的键会覆盖原有值
    val m4 = m3 + ("scala3"->30)
    println(s"m4=$m4") // scala3的值被覆盖为30
    println(s"原m3=$m3") // 原集合不变

    // 3. 删除键值对
    val m5 = m4 - "scala4" // 删除单个键
    val m6 = m5 - "scala4" - "scala3" // 批量删除,不存在的键会忽略
    println(s"m6=$m6") // 输出:m6=Map(scala1 -> 1, scala2 -> 2, scala5 -> 5)
  }
}
2.2.3 遍历操作
Scala 提供多种遍历 Map 的方式,适配不同的业务场景:
object RunMap {
  def main(args: Array[String]): Unit = {
    val mm1 = Map("java1"->1, "java2"->2, "java3"->3)

    // 1. 遍历键值对元组
    for((k,v) <- mm1) println(s"for key=$k,value=$v")
    mm1.foreach(x => println(s"foreach key=${x._1},value=${x._2}"))

    // 2. 只遍历键
    mm1.keySet.foreach(println(_))
    // 3. 只遍历值
    mm1.values.foreach(println(_))
  }
}
2.3 可变 Map 常用操作
可变 Map 支持在原集合上直接修改键值对,无需生成新 Map,性能更高,适合高频更新、索引构建的场景,对应课程源码RunMap.scala。
import scala.collection.mutable

object RunMap {
  def main(args: Array[String]): Unit = {
    // 创建可变Map
    val mm1 = mutable.Map("java1"->1, "java2"->2)

    // 1. 添加/更新键值对
    mm1("java3") = 3 // 键不存在则添加,存在则更新
    val r1 = mm1.put("java3", 3) // put方法返回旧值,键不存在返回None
    val r2 = mm1.put("java1", 10) // 键存在返回Some(旧值)
    println(s"r1=$r1, r2=$r2") // 输出:r1=None, r2=Some(1)
    println(s"mm1=$mm1") // 输出:mm1=HashMap(java1 -> 10, java2 -> 2, java3 -> 3)

    // 批量添加
    mm1 += ("java4"->4, "java5"->5)
    mm1 ++= Map("java6"->6, "java7"->7)

    // 2. 删除键值对
    val re1 = mm1.remove("java1") // remove返回被删除的值,键不存在返回None
    val re2 = mm1.remove("java8")
    println(s"re1=$re1, re2=$re2") // 输出:re1=Some(10), re2=None
    mm1 -= "java2" // 单个删除
    mm1 --= List("java3", "java4") // 批量删除
    println(s"remove mm1=$mm1") // 输出:remove mm1=HashMap(java5 -> 5, java6 -> 6, java7 -> 7)

    // 3. 清空Map
    mm1.clear()
    println(s"clear mm1=$mm1") // 输出:clear mm1=HashMap()
  }
}
2.4 Map 高级操作
对应课程源码RunMapSFM.scala,Map 提供了丰富的过滤、排序、最值等高级操作,是大数据数据处理的核心能力。
2.4.1 过滤操作
import scala.collection.mutable

object RunMapSFM {
  def main(args: Array[String]): Unit = {
    // 可变Map条件过滤:retain保留满足条件的键值对,直接修改原Map
    val mp = mutable.Map(1->"a", 2->"b", 3->"c")
    mp.retain((k,v) => k > 2) // 保留键>2的元素
    println(s"mp=$mp") // 输出:mp=HashMap(3 -> c)

    // 不可变Map过滤:filterKeys按键过滤,filter按KV过滤,返回新Map
    val m = Map(4->"d", 5->"e", 6->"f")
    val m1 = m.filterKeys(_ > 4) // 按键过滤,保留键>4的元素
    val m2 = m.filterKeys(Set(4,6)) // 保留键在Set中的元素
    val m3 = m.filter(x => x._1 > 5) // 按完整KV过滤
    println(s"m1=$m1") // 输出:m1=Map(5 -> e, 6 -> f)
    println(s"m2=$m2") // 输出:m2=Map(4 -> d, 6 -> f)
    println(s"m3=$m3") // 输出:m3=Map(6 -> f)
  }
}
2.4.2 最值操作
object RunMapSFM {
  def main(args: Array[String]): Unit = {
    val mm = Map("ab"->12, "e"->4, "byyy"->99, "muuuuu"->17)

    // 1. 按键的字典序取最值
    val mm1 = mm.max
    val min1 = mm.min
    println(s"按键排序max=$mm1, min=$min1") // 输出:按键排序max=(muuuuu,17), min=(ab,12)

    // 2. 按值取最值
    val minv = mm.valuesIterator.min
    val maxv = mm.valuesIterator.max
    println(s"值min=$minv, 值max=$maxv") // 输出:值min=4, 值max=99

    // 3. 按键的长度取最值
    val maxKeyLength = mm.keysIterator.reduceLeft((x,y) => if(x.length > y.length) x else y)
    println(s"最长的键=$maxKeyLength") // 输出:最长的键=muuuuu
  }
}
2.4.3 排序操作
Map 本身是无序的,排序后会转为 Seq 序列,可再转回 Map(注意:普通 HashMap 会丢失排序,需用 SortedMap/ListMap 保留排序)。
object RunMapSFM {
  def main(args: Array[String]): Unit = {
    val mm = Map("ab"->12, "e"->4, "byyy"->99, "muuuuu"->17)

    // 1. 按键升序排序
    val sq1 = mm.toSeq.sortBy(_._1)
    // 2. 按值升序排序
    val sq2 = mm.toSeq.sortBy(_._2)
    // 3. 按值降序排序
    val sq3 = mm.toSeq.sortWith(_._2 > _._2)

    println(s"按键升序=$sq1") // 输出:List((ab,12), (byyy,99), (e,4), (muuuuu,17))
    println(s"按值升序=$sq2") // 输出:List((e,4), (ab,12), (muuuuu,17), (byyy,99))
    println(s"按值降序=$sq3") // 输出:List((byyy,99), (muuuuu,17), (ab,12), (e,4))

    // 转回有序Map:ListMap保留插入/排序顺序
    val sortedMap = sq3.to(ListMap)
    println(s"有序Map=$sortedMap")
  }
}
第三章 Scala 集合性能选型指南
Scala 提供了丰富的集合实现类,不同集合的操作性能差异极大,大数据场景下,集合选型直接决定了程序的执行效率和内存占用,课程中重点讲解了各类集合的性能特性。
3.1 核心性能指标说明
表格中性能标识说明:
- eC:常数时间 O (1),效率极高
- C:接近常数时间,受分块等因素影响极小
- Log:对数时间 O (log n),效率优秀
- L:线性时间 O (n),效率随元素数量增长线性下降
- aC:均摊常数时间,大部分情况 O (1),少数情况 O (n)
3.2 不可变序列性能对比
| 集合类型 | head 头操作 | tail 尾部操作 | apply 索引访问 | update 更新 | prepend 头部添加 | append 尾部添加 | insert 中间插入 |
|---|---|---|---|---|---|---|---|
| List | eC | eC | L | L | eC | L | L |
| Vector | eC | eC | eC | eC | eC | eC | L |
| Range | eC | eC | eC | - | - | - | - |
| String | eC | L | eC | L | L | L | L |
选型结论:
- 频繁头部增删、顺序遍历:优先选List
- 频繁随机访问、头尾增删:优先选Vector(通用不可变序列首选)
- 固定数值区间:优先选Range,几乎不占用内存
3.3 可变序列性能对比
| 集合类型 | head 头操作 | tail 尾部操作 | apply 索引访问 | update 更新 | prepend 头部添加 | append 尾部添加 | insert 中间插入 |
|---|---|---|---|---|---|---|---|
| ArrayBuffer | eC | L | eC | eC | L | aC | L |
| ListBuffer | eC | eC | L | L | eC | aC | L |
| StringBuilder | eC | L | eC | eC | L | aC | L |
| Array | eC | - | eC | eC | - | - | - |
选型结论:
- 频繁随机访问、尾部增删:优先选ArrayBuffer(通用可变序列首选)
- 频繁头尾增删、顺序遍历:优先选ListBuffer
- 字符串拼接:优先选StringBuilder
- 固定长度、数值计算:优先选Array
3.4 Map/Set 性能对比
| 集合类型 | lookup 查询 | add 添加 | remove 删除 | min 最小值 | 适用场景 |
|---|---|---|---|---|---|
| 不可变 HashMap/HashSet | eC | eC | eC | L | 通用场景,高频增删查 |
| 可变 HashMap/HashSet | eC | eC | eC | L | 局部高频更新、大数据量索引构建 |
| TreeMap/TreeSet | Log | Log | Log | eC | 需要按键排序的场景 |
| BitSet | eC | eC | eC | eC | 非负整型数据的去重、判重 |
| ListMap/ListSet | L | L | L | L | 需要保留插入顺序的小数据量场景 |
3.5 大数据场景下的集合选型最佳实践
- 优先使用不可变集合:不可变集合线程安全、无副作用,完美适配 Spark 分布式不可变 RDD 模型,避免并发修改导致的数据异常,仅在局部单线程高频增删的场景下使用可变集合。
- 判重 / 去重优先用 Set:Set 的
contains方法是 O (1),远优于 Seq 的 O (n),大数据量去重、判重绝对禁止用 List 的contains。 - 索引构建优先用可变 HashMap:大数据场景下构建字符 / 数据索引,优先使用
mutable.HashMap,避免不可变 Map 频繁创建新集合带来的性能开销。 - 排序场景用 SortedSet/SortedMap:需要有序的 KV / 去重数据,优先使用 TreeSet/TreeMap,避免手动排序带来的性能损耗。
- 超大集合遍历用迭代器:百万级以上的超大集合,优先使用迭代器遍历,避免一次性加载所有数据到内存导致 OOM。
第四章 Scala 模式匹配
模式匹配是 Scala 最具特色、最强大的语法特性,类似于 Java 的switch case,但功能远更强大,支持常量、变量、类型、元组、集合、样例类等多种匹配模式,是 Scala 函数式编程的核心语法,Spark 源码中随处可见模式匹配的应用。
4.1 模式匹配核心概述
4.1.1 与 Java switch 的核心差异
| 特性 | Scala 模式匹配 | Java switch case |
|---|---|---|
| 匹配类型 | 支持常量、变量、类型、元组、集合、样例类等几乎所有类型 | 仅支持 byte、short、int、char、枚举、String(Java7+) |
| 穿透性 | 无 case 穿透问题,匹配成功后自动终止,无需 break | 默认 case 穿透,必须手动加 break 终止,否则会执行后续所有 case |
| 返回值 | 每个 case 都可返回值,整个 match 表达式有返回值 | 无返回值,仅能执行语句 |
| 守卫条件 | 支持 if 守卫条件,实现复杂的条件匹配 | 仅能在 case 中写 if 判断,无原生守卫支持 |
| 变量绑定 | 支持变量绑定,可在匹配的同时给匹配的内容赋值变量 | 无此特性 |
4.1.2 基础语法
待匹配的值 match {
  case 匹配模式1 => 执行语句/返回值
  case 匹配模式2 => 执行语句/返回值
  case _ => 兜底默认执行语句/返回值 // 通配符_匹配所有情况,必须放在最后
}- 匹配规则:从上到下依次匹配,匹配到第一个符合的 case 后立即执行,不会穿透到后续 case;
- 兜底规则:必须用
case _处理所有未匹配的情况,否则会抛出MatchError异常; - 返回值:整个 match 表达式会返回匹配到的 case 的执行结果,可直接赋值给变量。
4.1.3 基础示例
对应课程源码RunModel.scala,最基础的常量模式匹配:
object RunModel {
  def main(args: Array[String]): Unit = {
    // 基础匹配:1-5的奇数匹配,偶数兜底
    for (i <- 1 to 5) {
      i match {
        case 1 => println(1)
        case 3 => println(3)
        case 5 => println(5)
        case _ => println("even") // 兜底,匹配所有其他情况
      }
    }

    // 多类型常量匹配
    def patternShow(x: Any) = x match {
      case Nil => println("empty List")
      case null => println("null")
      case true => println("true")
      case "scala" => println("scala")
      case _ => println("default")
    }
    patternShow(List()) // 输出:empty List
    patternShow(null) // 输出:null
    patternShow(100) // 输出:default
  }
}
4.2 8 种常用模式匹配类型
课程中重点讲解了 8 种常用的模式匹配类型,覆盖了绝大多数业务场景,对应源码RunModel.scala。
4.2.1 常量模式
常量模式用于匹配指定的常量值,是最基础的模式匹配,支持所有字面量常量(数字、字符串、布尔值、单例对象等)。
def constantMatch(x: Any): String = x match {
  case 1 => "数字1"
  case "hello" => "字符串hello"
  case true => "布尔值true"
  case Nil => "空列表"
  case _ => "未知常量"
}
4.2.2 变量模式
变量模式会将匹配到的值赋值给定义的变量,可在 case 语句中使用该变量,变量模式会匹配所有值,因此必须放在兜底case _之前,或配合守卫使用。
object RunModel {
  def main(args: Array[String]): Unit = {
    def patterVarible(x: Any) = x match {
      case x => println(s"匹配到变量x=$x") // 变量模式,匹配所有值
      // 注意:后续case永远不会执行,因为变量模式已经匹配了所有值,编译器会警告
    }
    patterVarible(1) // 输出:匹配到变量x=1
  }
}
4.2.3 守卫模式(if 条件匹配)
守卫模式通过if条件表达式,给 case 添加额外的匹配条件,实现复杂的逻辑匹配,是模式匹配中最常用的扩展功能。
object RunModel {
  def main(args: Array[String]): Unit = {
    // 奇偶判断,配合守卫模式
    for (i <- 1 to 10) {
      i match {
        case x if x % 2 == 0 => println(s"$x 是偶数")
        case _ => println(s"$i 是奇数")
      }
    }

    // 范围匹配
    def rangeMatch(x: Int): String = x match {
      case x if x > 0 && x < 10 => "0-10之间"
      case x if x >= 10 && x < 100 => "10-100之间"
      case _ => "超出范围"
    }
  }
}
4.2.4 元组模式
元组模式用于匹配元组,可精准匹配元组的长度、指定位置的元素,支持通配符_忽略不需要的元素。
object RunModel {
  def main(args: Array[String]): Unit = {
    val t1 = (2, 3)
    val t2 = (4, 5, 6)
    val t3 = (7, 8, 9, 0)
    val t4 = (1, 2, 3, 4, 5)

    def patterTuple(x: Any) = x match {
      case (first, second) => println(s"二元组:first=$first,second=$second")
      case (x1, x2, x3, x4) => println(s"四元组:first=$x1,second=$x2,x3=$x3,x4=$x4")
      case (x1, _, _, _, x5) => println(s"五元组:第一个=$x1,第五个=$x5") // 用_忽略中间元素
      case _ => println("其他元组")
    }

    patterTuple(t1) // 输出:二元组:first=2,second=3
    patterTuple(t2) // 输出:其他元组
    patterTuple(t3) // 输出:四元组:first=7,second=8,x3=9,x4=0
    patterTuple(t4) // 输出:五元组:第一个=1,第五个=5
  }
}
4.2.5 序列 / 集合模式
序列模式用于匹配数组、List 等集合,可精准匹配集合的长度、指定位置的元素,支持_*通配符匹配剩余的所有元素。
object RunModel {
  def main(args: Array[String]): Unit = {
    val arr = Array(1, 3, 6, 7)
    val list = List(2, 9)
    val list1 = List(2, 3, 45, 56, 6, 0, 199)
    val list2 = List(2)

    def patterSeq(x: Any) = x match {
      case Array(first, second) => println(s"二元数组:first=$first,second=$second")
      case Array(x1, x2, x3, x4) => println(s"四元数组:first=$x1,second=$x2,x3=$x3,x4=$x4")
      case List(first, second, _*) => println(s"列表:第一个=$first,第二个=$second,后续元素忽略") // _*匹配剩余所有元素
      case _ => println("其他集合")
    }

    patterSeq(arr) // 输出:四元数组:first=1,second=3,x3=6,x4=7
    patterSeq(list) // 输出:列表:第一个=2,第二个=9,后续元素忽略
    patterSeq(list1) // 输出:列表:第一个=2,第二个=3,后续元素忽略
    patterSeq(list2) // 输出:其他集合(长度不足2)
  }
}
4.2.6 类型模式
类型模式用于匹配值的类型,替代 Java 中的instanceof类型判断,语法更简洁,同时会自动进行类型转换,无需强制类型转换。
object RunModel {
  def main(args: Array[String]): Unit = {
    class A08
    class B08 extends A08

    def patterType(x: Any) = x match {
      case s: String => println("匹配到String类型")
      case s: Int => println("匹配到Int类型")
      case s: Double => println("匹配到Double类型")
      case a: A08 => println("匹配到A08类型")
      case 88 => println("匹配到常量88") // 常量模式可与类型模式混用
      case _ => println("其他类型")
    }

    patterType(3) // 输出:匹配到Int类型
    patterType("scala") // 输出:匹配到String类型
    patterType(2.0) // 输出:匹配到Double类型
    patterType(true) // 输出:其他类型
    patterType(88) // 输出:匹配到常量88
    patterType(new B08()) // 输出:匹配到A08类型(多态匹配)
  }
}
注意:类型匹配会遵循多态规则,子类实例会匹配到父类类型,因此父类类型的 case 要放在子类之后。
4.2.7 构造器模式
构造器模式是模式匹配最强大的功能之一,用于匹配样例类(case class)的构造参数,可精准匹配样例类的属性值,支持嵌套匹配,是 Spark 中样例类数据解析的核心方式。
核心前提
样例类会自动生成unapply解构方法,这是构造器模式的基础,普通类需手动实现unapply方法才能支持构造器模式。
object RunModel {
  def main(args: Array[String]): Unit = {
    // 样例类,自动支持构造器模式
    case class Dog08(var name:String, val age:Int)
    // 普通类,手动实现unapply方法支持构造器模式
    class Dog07(var name:String, val age:Int){
      override def toString = s"Dog07($name, $age)"
    }
    object Dog07{
      // 手动实现unapply解构方法
      def unapply(arg: Dog07): Option[(String, Int)] = if (arg!=null) Some(arg.name,arg.age) else None
    }

    def patterConstrcutor(x: Any) = x match {
      case Dog08(name, age) => println(s"Dog08:name=$name,age=$age") // 匹配所有属性
      case Dog08(_, age) => println(s"Dog08:仅匹配年龄age=$age") // 用_忽略不需要的属性
      case d@Dog07(name, age) => println(s"Dog07完整对象=$d, name=$name,age=$age") // 变量绑定
      case _ => println("其他对象")
    }

    patterConstrcutor(Dog08("wangwang",30)) // 输出:Dog08:name=wangwang,age=30
    patterConstrcutor(Dog07("wangwang07",70)) // 输出:Dog07完整对象=Dog07(wangwang07, 70), name=wangwang07,age=70
  }
}
4.2.8 变量绑定模式
变量绑定模式通过变量名@的语法,在匹配模式的同时,将整个匹配到的对象赋值给变量,可在 case 语句中直接使用该对象,无需重新构建。
object RunModel {
  def main(args: Array[String]): Unit = {
    val list_1 = List(List(1,2,3,4), List(4,5,6,7,8,9,10))

    def patterBind(x: Any) = x match {
      // e1绑定整个外层List,e2绑定内层的第二个List
      case e1@List(_, e2@List(5, _*)) => println(s"外层List=$e1, 内层List=$e2")
      case _ => println("其他列表")
    }

    patterBind(list_1) // 输出:外层List=List(List(1, 2, 3, 4), List(4, 5, 6, 7, 8, 9, 10)), 内层List=List(5, 6, 7, 8, 9, 10)
  }
}
4.3 模式匹配的注意事项
- case 顺序问题:匹配规则是从上到下,范围大的 case 必须放在范围小的 case 之后,否则后续 case 永远不会执行,编译器会给出警告。
- 兜底 case 必须有:必须用
case _处理所有未匹配的情况,否则运行时会抛出MatchError异常。 - 无 case 穿透:Scala 模式匹配匹配成功后自动终止,无需像 Java 一样加 break,不会出现 case 穿透问题。
- 样例类优先:构造器模式优先使用样例类,无需手动实现 unapply 方法,语法更简洁,避免手动实现的错误。
- 泛型擦除问题:类型模式无法匹配泛型类型(如
List[String]),因为 JVM 有泛型擦除,运行时无法获取泛型参数,仅能匹配List[_]。
第五章 课后作业全解析
对应课程配套作业文档,包含简答题与编程题全解析,所有代码可直接复制运行。
一、简答题
(1)Scala 有哪些模式匹配?
答:Scala 模式匹配功能极其强大,提供了 8 种常用的匹配模式,覆盖了绝大多数业务场景,具体分类如下:
- 常量模式:匹配指定的字面量常量,如数字、字符串、布尔值、单例对象、空集合 Nil 等,是最基础的模式匹配。
- 变量模式:将匹配到的值赋值给定义的变量,可在 case 语句中使用该变量,会匹配所有输入值。
- 守卫模式:在 case 中通过
if条件表达式添加额外的匹配规则,实现复杂的条件匹配,如范围判断、奇偶判断等。 - 元组模式:匹配元组类型,可精准匹配元组的长度、指定位置的元素,支持通配符
_忽略不需要的元素。 - 序列 / 集合模式:匹配数组、List 等集合类型,可精准匹配集合长度、指定位置元素,支持
_*通配符匹配剩余所有元素。 - 类型模式:匹配值的类型,替代 Java 的
instanceof判断,同时自动完成类型转换,无需强制类型转换,支持多态匹配。 - 构造器模式:针对样例类(case class)的核心匹配模式,可精准匹配样例类的构造参数,支持嵌套匹配,是 Scala 模式匹配最强大的功能。
- 变量绑定模式:通过
@语法,在匹配的同时将整个匹配对象赋值给变量,可在 case 语句中直接使用完整的匹配对象。
除此之外,Scala 还支持可选值 Option 模式、正则表达式模式、提取器模式等高级匹配模式,可适配更复杂的业务场景。
二、编程题
(1)利用模式匹配编写一个 swap 函数,用于交换数组中的前两个元素的位置(数组长度 > 2)。
object Homework1 {
  /**
   * 交换数组前两个元素的位置,使用模式匹配实现
   * @param arr 输入的数组,要求长度>2
   * @return 交换后的新数组,原数组保持不变
   */
  def swap(arr: Array[Any]): Array[Any] = {
    // 模式匹配数组的前两个元素,剩余元素用_*匹配
    arr match {
      // 匹配至少两个元素的数组,交换前两个,剩余元素保持不变
      case Array(first, second, rest @ _*) => Array(second, first) ++ rest
      // 数组长度不足2,直接返回原数组
      case _ => arr
    }
  }

  def main(args: Array[String]): Unit = {
    // 测试用例
    val testArr1 = Array(1,2,3,4,5)
    val testArr2 = Array("scala","java","python","c")
    val testArr3 = Array(1) // 长度不足2
    val testArr4 = Array(true, false, 10.5, "hello")

    println(s"原数组:${testArr1.mkString(",")},交换后:${swap(testArr1).mkString(",")}")
    println(s"原数组:${testArr2.mkString(",")},交换后:${swap(testArr2).mkString(",")}")
    println(s"原数组:${testArr3.mkString(",")},交换后:${swap(testArr3).mkString(",")}")
    println(s"原数组:${testArr4.mkString(",")},交换后:${swap(testArr4).mkString(",")}")
  }
}
(2)编写一个函数,计算 List [Option [Int]] 中所有非 None 值的和,不得使用 match 语句。
object Homework2 {
  /**
   * 计算List[Option[Int]]中所有非None值的和,不使用match语句
   * @param list 输入的Option[Int]列表
   * @return 所有非None值的总和
   */
  def sumOptionList(list: List[Option[Int]]): Int = {
    // 方案1:flatMap展开Option,自动过滤None,再求和
    list.flatMap(option => option).sum

    // 方案2:foldLeft折叠求和
    // list.foldLeft(0)((acc, opt) => acc + opt.getOrElse(0))

    // 方案3:filter过滤Some,map取值,再求和
    // list.filter(_.isDefined).map(_.get).sum
  }

  def main(args: Array[String]): Unit = {
    val testList = List(Some(1), None, Some(3), Some(5), None, Some(10))
    val emptyList = List(None, None, None)
    val fullList = List(Some(2), Some(4), Some(6))

    println(s"测试列表总和:${sumOptionList(testList)}") // 输出:1+3+5+10=19
    println(s"空列表总和:${sumOptionList(emptyList)}") // 输出:0
    println(s"全值列表总和:${sumOptionList(fullList)}") // 输出:12
  }
}
(3)制作这样的树更好的做法是使用样例类。我们不妨从二叉树开始,编写一个函数计算所有叶子节点中的元素之和。
样例类定义:
sealed abstract class BinaryTree
case class Leaf(value : Int) extends BinaryTree
case class Node(left : BinaryTree,right : BinaryTree) extends BinaryTree// 二叉树样例类定义
sealed abstract class BinaryTree
case class Leaf(value : Int) extends BinaryTree
case class Node(left : BinaryTree, right : BinaryTree) extends BinaryTree
object Homework3 {
/**
* 递归计算二叉树所有叶子节点的元素之和
* @param tree 二叉树根节点
* @return 所有叶子节点的值总和
*/
def sumLeaf(tree: BinaryTree): Int = tree match {
// 叶子节点,直接返回值
case Leaf(value) => value
// 分支节点,递归计算左右子树的叶子和,相加
case Node(left, right) => sumLeaf(left) + sumLeaf(right)
}
def main(args: Array[String]): Unit = {
// 构建测试二叉树:
// root
// / \
// node1 node2
// / \ \
// Leaf(3) Leaf(8) Leaf(5)
val testTree = Node(
Node(Leaf(3), Leaf(8)),
Node(Leaf(2), Leaf(5))
)
// 单叶子节点测试
val singleLeaf = Leaf(10)
// 空分支测试
val emptyTree = Node(Leaf(1), Node(Leaf(2), Leaf(3)))
println(s"测试二叉树叶子总和:${sumLeaf(testTree)}") // 输出:3+8+2+5=18
println(s"单叶子节点总和:${sumLeaf(singleLeaf)}") // 输出:10
println(s"三层二叉树总和:${sumLeaf(emptyTree)}") // 输出:1+2+3=6
}
}(4)编写一个函数,给定字符串,产生出一个包含所有字符的下标的映射。举例来说,index ("Mississippi") 应返回一个映射,让 'M' 对应集 {0},'i' 对应集 {1,4,7,10},依此类推。使用字符到可变集的映射。另外,你如何保证集是经过排序的?
import scala.collection.mutable

object Homework4 {
  /**
   * 构建字符串中每个字符的下标映射
   * @param str 输入的字符串
   * @param sorted 是否返回排序的下标集,默认true
   * @return 字符到下标集的映射,key为字符,value为该字符出现的所有下标
   */
  def charIndexMap(str: String, sorted: Boolean = true): Map[Char, Set[Int]] = {
    // 1. 创建可变Map,key为字符,value为可变的下标集
    val indexMap = mutable.Map[Char, mutable.Set[Int]]()

    // 2. 遍历字符串,记录每个字符的下标
    for ((char, index) <- str.zipWithIndex) {
      // 如果字符不存在,初始化空集;存在则直接添加下标
      indexMap.getOrElseUpdate(char,
        if (sorted) mutable.SortedSet else mutable.HashSet
      ) += index
    }

    // 3. 转为不可变Map返回
    indexMap.mapValues(_.toSet).toMap
  }

  def main(args: Array[String]): Unit = {
    val testStr = "Mississippi"
    val result = charIndexMap(testStr)
    val unSortedResult = charIndexMap(testStr, sorted = false)

    println(s"字符串:$testStr")
    println("排序后的下标映射:")
    result.foreach{ case (char, indexes) =>
      println(s"$char -> $indexes")
    }

    // 输出结果:
    // M -> TreeSet(0)
    // i -> TreeSet(1, 4, 7, 10)
    // s -> TreeSet(2, 3, 5, 6)
    // p -> TreeSet(8, 9)
  }
}
排序保证方案:
- 使用
SortedSet(默认实现 TreeSet)替代普通的 HashSet,SortedSet会自动对下标进行升序排序;- 遍历字符串时,下标是从小到大递增的,也可使用
LinkedHashSet保留插入顺序,实现下标有序;- 最终返回时,可通过
toList.sorted.toSet对下标集进行排序,保证结果有序。
学习总结
- Set 集合:Set 是无序、元素不可重复的集合,核心作用是去重和快速判重,
contains方法 O (1) 的时间复杂度远优于 Seq,大数据场景下判重优先使用 Set;分为不可变 Set(默认)和可变 Set,特殊实现类 SortedSet 可实现元素排序,LinkedHashSet 可保留插入顺序。 - Map 集合:Map 是 KV 键值对集合,是大数据索引构建、数据关联的核心工具,分为不可变 Map(默认)和可变 Map;不可变 Map 线程安全,适合常量映射;可变 Map 性能更高,适合高频更新的索引构建;Map 提供了丰富的过滤、排序、最值操作,Spark PairRDD 的算子设计完全对标 Map 的操作逻辑。
- 集合性能选型:大数据场景下,集合选型直接决定程序性能,通用场景不可变集合优先选 Vector,可变集合优先选 ArrayBuffer;高频增删查选 HashMap/HashSet,排序场景选 TreeMap/TreeSet,绝对禁止用 List 做大数据量的判重操作。
- 模式匹配:模式匹配是 Scala 最具特色的语法,功能远强于 Java 的 switch case,支持 8 种常用匹配模式,无 case 穿透问题,每个 case 都有返回值;构造器模式配合样例类,可实现复杂的对象解构,是 Spark 数据解析、异常处理、分支判断的核心语法,在 Spark 源码中随处可见。
- 大数据开发适配:Scala 的 Set、Map 操作是 Spark RDD 算子的基础,模式匹配是 Spark 业务开发的必备语法,掌握本章内容,就掌握了 Spark 大数据开发的核心语法基础,能够大幅提升 Spark 业务代码的开发效率和可读性。
下一章预习内容:Scala 隐式转换、Scala 与 Java 交互。