3 Hive 集群部署完整教程
一. 大数据架构与存储
1 核心组件
在大数据系统的构建中,核心组件如同“加工工厂”的不同车间。在 2026 年的现代架构(特别是存算分离与湖仓一体普及后)下,这些组件的职责划分更加明确。
1. 数据采集层 (Data Ingestion) —— 工厂的入口
负责将分布在业务数据库(MySQL、PostgreSQL)、日志文件、移动端埋点等处的原始数据同步到大数据系统。
- Kafka: 分布式流处理平台,充当“缓冲池”,解决上下游读写速度不匹配的问题。
- Flink CDC: 实时捕获数据库变更(Change Data Capture)并同步到湖仓,是目前实时入湖的首选。
- Canal: 专门针对 MySQL 的 Binlog 解析工具。
- Logstash / Fluentd: 常用于日志文件的收集与过滤。
2. 数据存储层 (Data Storage) —— 工厂的仓库
现代架构倾向于将数据存储在廉价的对象存储中,并辅以特定的“表格式”来管理。
- Amazon S3 / MinIO / Ceph: 云原生对象存储,作为存算分离的物理底座,成本远低于传统 HDFS。
- HDFS: 经典的分布式文件系统,在私有云/本地部署环境下依然稳健。
- Apache Iceberg / Delta Lake: 湖仓一体的关键。 它们在文件之上提供 ACID 事务、版本回溯和模式演进能力。
- OceanBase / HBase: 提供高性能的随机读写能力。OceanBase 兼顾 SQL 事务,HBase 适合海量 KV 存储。
3. 计算引擎层 (Data Processing) —— 加工车间
负责对原始数据进行清洗、转换、聚合及机器学习计算。
- Spark: 目前最主流的通用计算引擎。擅长离线批处理、复杂 ETL 以及大规模机器学习。
- Flink: 实时计算领域的霸主。主打低延迟流处理,实现“数据产生即计算”。
- MapReduce: 经典的批处理模型,虽已逐渐被 Spark 替代,但在超大规模稳定性场景仍有应用。
4. 数据分析与查询层 (Data Analysis / OLAP) —— 质检与成品区
让用户能够通过 SQL 快速获取报表数据或进行交互式分析。
- Hive: 基于 HDFS 的数仓工具,负责定义元数据,将文件映射为“表”。
- StarRocks / ClickHouse: 极速 OLAP 引擎。专门优化了多维分析性能,通常用于秒级响应的业务大屏。
- Presto / Trino: 交互式查询引擎,擅长跨数据源(如同时查 S3 和 MySQL)的即时分析。
5. 资源调度与集群管理 (Resource Management) —— 总调度室
负责给上述所有组件分配 CPU 和内存资源。
- Kubernetes (K8s): 云原生时代的事实标准。 现在主流的 Spark、Flink 和 StarRocks 任务都倾向于运行在容器化的 K8s 环境中。
- YARN: Hadoop 生态的经典调度器,在传统的 HDFS 环境中依然占据主流地位。
- Zookeeper / Etcd: 负责分布式协调、主从选举和配置管理。
2 存储技术
在大数据存储领域,技术选型早已跨越了单纯的“存数据”阶段,演变为对成本、吞吐量、数据一致性以及实时性的综合博弈。
1. 大数据存储技术分类(按架构范式)
分布式文件存储 (Distributed File Storage)
- 代表技术: HDFS (Hadoop Distributed File System)。
- 特点: 将大文件切分为固定大小的块(Block),跨节点冗余存储。
- 适用: 传统的离线批处理(Spark/MapReduce),适合高吞吐量的顺序读写。
云原生对象存储 (Object Storage)
- 代表技术: Amazon S3, MinIO, Ceph。
- 特点: 扁平化存储结构,通过 REST API 访问。它是存算分离架构的物理底座。
- 适用: 海量非结构化数据(图片、视频)、冷热数据分层、云原生数仓底座。
宽表与分布式数据库 (NoSQL / NewSQL)
- 代表技术: HBase, OceanBase。
- 特点: * HBase: 基于 HDFS,擅长海量半结构化数据的随机实时读写。
- OceanBase: 分布式关系型数据库,兼顾 SQL 事务(OLTP)和大规模分析(OLAP)。
- 适用: 实时账单查询、高并发业务订单、核心交易系统。
湖仓一体核心层 (Lakehouse Table Formats)
- 代表技术: Apache Iceberg, Delta Lake, Apache Hudi。
- 特点: 在对象存储之上,赋予文件 ACID 事务、版本回溯(Time Travel)和模式演进能力。
- 适用: 解决数据湖“只增不删”的痛点,支持流批一体。
2. 核心主流产品选型对比
| 产品名称 | 技术阵营 | 核心定位 | 存储模型 | 优点 | 局限性 |
|---|---|---|---|---|---|
| HDFS | 开源 | 经典分布式底座 | 块 (Block) | 生态极成熟,吞吐量高 | 存算耦合,维护复杂 |
| Amazon S3 | 商用 | 云原生标准 | 对象 (Object) | 11 个 9 可靠性,弹性无限 | 跨区域带宽成本高 |
| MinIO | 开源 | 高性能 S3 适配 | 对象 (Object) | 极轻量,读写性能极强 | 元数据治理弱于商业版 |
| OceanBase | 商用 | 分布式强一致库 | 结构化/KV | 兼容 HBase, 事务强一致 | 学习门槛相对较高 |
| HBase | 开源 | NoSQL 宽表 | KV / 宽表 | 随机查写极快 | 依赖 HDFS,存在 GC 抖动 |
| Hive | 开源 | 元数据管理工具 | 逻辑表 | 使用 SQL 管理海量文件 | 延迟高,非真实数据库 |
| Alluxio | 开源 | 存储加速/编排 | 虚拟文件 | 解决存算分离的网络延迟 | 增加架构复杂度 |
| Ceph | 开源 | 统一存储平台 | 块/文件/对象 | 一套集群解决所有需求 | 运维门槛极高 |
3. 技术选型决策建议
在实际落地中,建议遵循以下**“三步走”**逻辑:
- 确定物理底座: 如果是本地部署且规模巨大,首选 HDFS 或 Ceph。
- 如果是云原生或追求弹性,首选 MinIO 或 Amazon S3。
- 确定数据治理层:
- 需要频繁更新(Update/Delete)数据?选择 Iceberg 或 Delta Lake。
- 仅是静态离线分析?使用 Hive 即可。
- 确定性能加速方案:
- 计算节点和存储节点不在同一个机房?引入 Alluxio 做缓存。
- 需要毫秒级点查?引入 OceanBase (OBKV) 或 HBase。
4. 商用 vs. 开源
| 维度 | 开源阵营 (HDFS, Ceph, MinIO) | 商用阵营 (S3, OceanBase) |
|---|---|---|
| 优势 | 社区活跃、无厂商锁定、可深度定制。 | 稳定性极高、开箱即用、原厂售后保障。 |
| 劣势 | 运维成本极高,需要专业的技术团队调优。 | 初期采购成本或订阅成本较高。 |
| 推荐建议 | 适合拥有强悍运维能力的互联网大厂或教学环境。 | 适合追求业务稳定性、希望快速落地的企业级项目。 |
二 认识Hive
什么是 Hive?
Hive 是由 Facebook 开源的,建立在 Hadoop 之上的数据仓库工具。它的核心价值在于:让不熟悉 Java/MapReduce 的分析师能够使用 SQL(称为 HQL)来处理大规模数据。
- 2007-2008年:Facebook 为了解决海量日志处理难题开发了 Hive。
- 2010年:成为 Apache 顶级项目。
- 现状:虽然 SparkSQL 和 Flink 崛起,但 Hive 凭借极其稳定的元数据管理(Metastore),依然是企业级“数据湖/数仓”的基石。
Hive 架构与原理
Hive 的设计初衷是简化 Hadoop 的使用,使不熟悉 MapReduce 的人员能够使用类 SQL 语言处理大数据 。
Hive 的本质是一个 SQL 解析引擎。它并不直接处理数据,而是将 SQL 翻译成 MapReduce 任务。
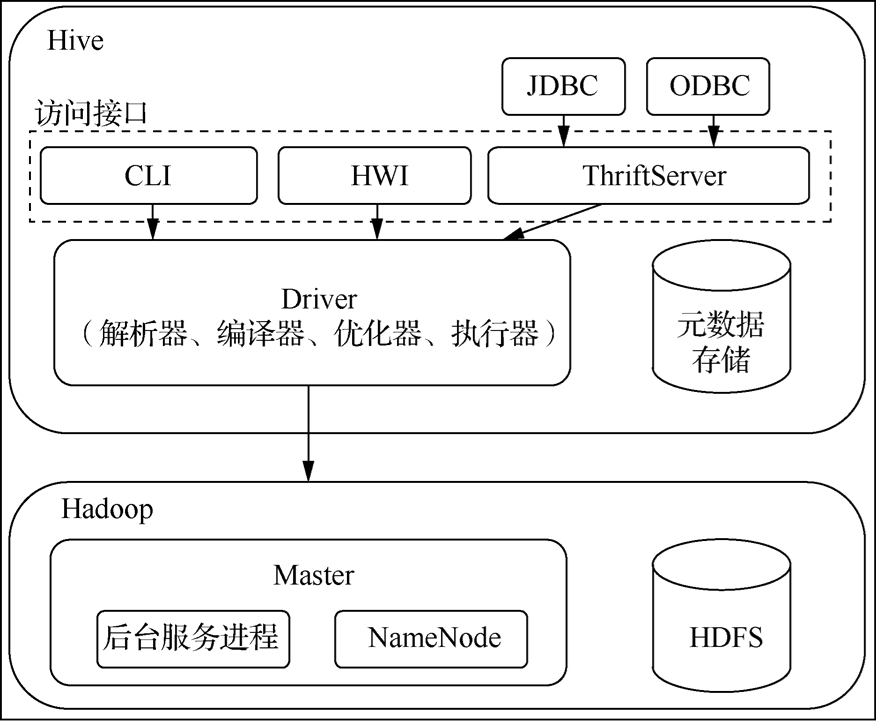
核心组件
- 用户接口:CLI (命令行)、JDBC/ODBC (用于连接可视化工具如 Tableau)。
- Thrift Server:跨语言服务,允许不同语言编写的客户端连接 Hive。
- Metastore (元数据库):存储表名、列名、分区、文件路径等元数据(如MySQL 或 Derby )。
- Driver (驱动程序):包含 Parser(解析 HQL)、Compiler(编译生成执行计划)、Optimizer(优化计划)和 Executor(执行作业) 。
工作原理步骤
- 用户提交 HQL 语句。
- Driver 结合 Metastore 进行语法校验和语义分析。
- Compiler 生成逻辑执行计划。
- Optimizer 进行优化(如列裁剪、谓词下推)。
- Executor 将计划转化为具体的 MapReduce 任务提交给 Hadoop 集群。
Hive的架构
Hive与传统数据库的区别
| 特性 | Hive (数据仓库) | 关系型数据库 (MySQL/Oracle) |
|---|---|---|
| 数据量 | PB 级 | GB/TB 级 |
| 查询延迟 | 高 (分钟/小时级) | 低 (毫秒/秒级) |
| 读写模式 | 读多写少 (不建议随机更新/删除) | 频繁增删改查 |
| 执行引擎 | MapReduce / Spark / Tez | 数据库自带引擎 |
| 索引 | 较弱 | 非常丰富 |
| 事务支持 | 部分支持 (ACID 较弱) | 完善的事务支持 |
| 使用场景 | 日志分析、数据仓库、离线报表生成、大规模ETL等 | 事务处理、实时查询、复杂的关联查询 |
Hive 的优势与局限
优势
- 低成本:运行在廉价的 PC 机器集群上。
- 易上手:SQL 背景的开发人员无需学习 Java 即可编写 MapReduce 逻辑。
- 生态丰富:与 Spark、Flink、HBase 等大数据组件无缝对接。
局限
- 延迟高:由于 MapReduce 启动开销大,不适合在线实时查询。
- 调优复杂:在处理“收视行为”这类巨大表关联时,容易出现数据倾斜,需要深入理解底层原理。
- 不适合小文件:过多的小文件会给元数据压力并降低计算效率。
- 非强事务:虽然近几年引入了 ACID 特性,但在超大规模并发修改下表现不如传统数据库。
三. Hive部署
环境说明
- Hive 只需安装在 Master 节点(Hive 是客户端工具,不需要每个节点都装)
- MySQL 安装在 Master 节点作为元数据库
- 集群已有:Hadoop 3.3.6 + ZooKeeper 3.8.3 + HBase 2.5.7
- 新增:Hive 3.1.3
- Hive 部署在 master节点(Hive是单节点服务,依赖Hadoop集群存储)
- 需要额外安装 MySQL 作为 Hive 元数据库
| 环境 | CentOS 7 / VMware / 1主3从 |
|---|---|
| Master | 192.168.128.130 |
| Slaves | 192.168.128.131~133 |
| Java | JDK 1.8.0_281 |
| Hadoop | 3.3.6 (hdfs://master:8020) |
| ZooKeeper | 3.8.3 |
| HBase | 2.5.7 |
| Hive | 3.1.3 |
| MySQL | 8.0.21 (元数据库) |
集群规划
Hive 只需部署在 Master 节点,Slave 节点无需安装任何组件。计算任务由 YARN 自动调度到各节点执行,数据存储在 HDFS 上。
| *组件* | *节点* | *说明* |
|---|---|---|
| MySQL 8.0.21 | master | 存储 Hive 元数据(库表结构) |
| Hive MetaStore :9083 | master | 元数据服务,Thrift 接口 |
| HiveServer2 :10000 | master | JDBC/ODBC 接入点 |
| Hive CLI / Beeline | master | 命令行客户端 |
| HDFS /user/hive/warehouse | 全部节点 | 实际数据存储位置 |
第一步:安装 MySQL 8.0.21(Master节点)
1.1 检查并卸载系统自带 MariaDB
rpm -qa | grep mariadb
# 如果有输出,执行下面命令卸载
rpm -e --nodeps mariadb-libs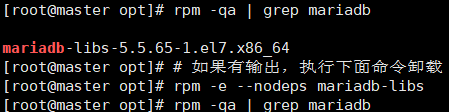
1.2 安装 MySQL RPM 包
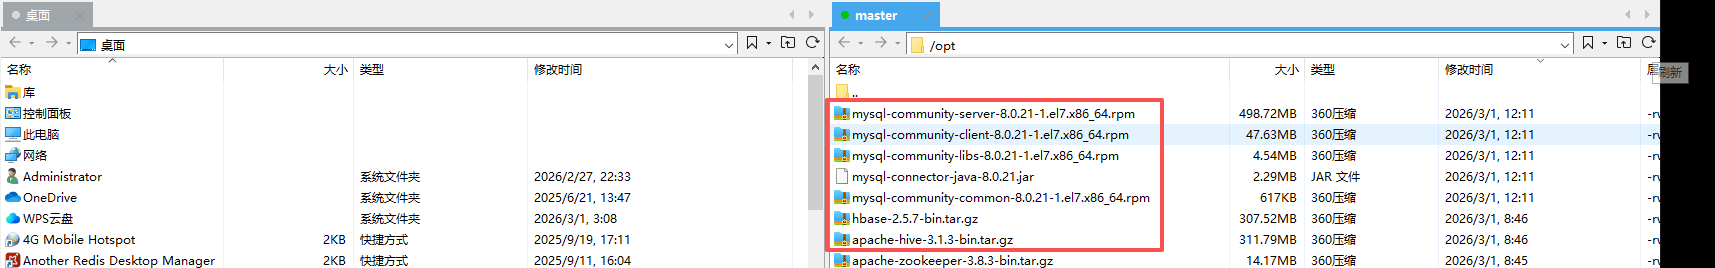
cd /opt

# 按顺序安装(顺序不能乱!)
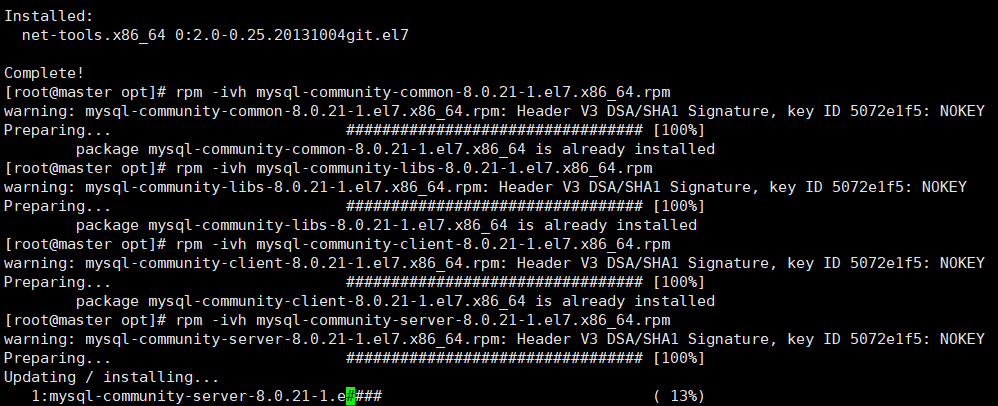
rpm -ivh mysql-community-common-8.0.21-1.el7.x86_64.rpm
rpm -ivh mysql-community-libs-8.0.21-1.el7.x86_64.rpm
rpm -ivh mysql-community-client-8.0.21-1.el7.x86_64.rpm
rpm -ivh mysql-community-server-8.0.21-1.el7.x86_64.rpm
如果报错缺少依赖,执行:
yum install -y libaio net-tools,再重新安装
1.3 启动 MySQL 服务
systemctl start mysqld
systemctl enable mysqld   # 设置开机自启
systemctl status mysqld   # 确认运行状态显示 active (running)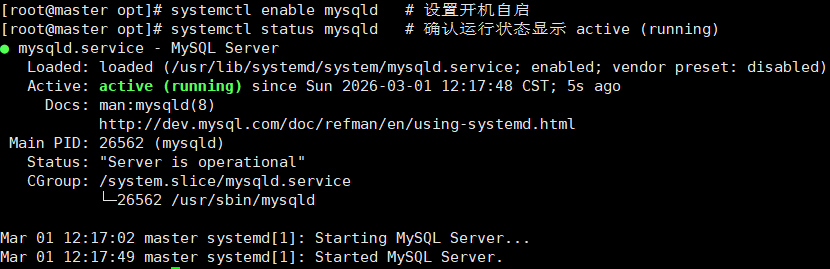
1.4 获取临时密码并修改
# 查看临时密码
grep 'temporary password' /var/log/mysqld.log
# 输出类似:... A temporary password is generated for root@localhost: xxxxxx
# 登录MySQL
mysql -u root -p
# 输入上面查到的临时密码
-- 修改root密码(MySQL8强制要求密码有大小写+数字+特殊字符)
ALTER USER 'root'@'localhost' IDENTIFIED BY 'Root@hive123';

-- 降低密码策略(可选,方便学习环境使用简单密码)
SET GLOBAL validate_password.policy = LOW;
SET GLOBAL validate_password.length = 4;
ALTER USER 'root'@'localhost' IDENTIFIED BY 'hive123';

FLUSH PRIVILEGES;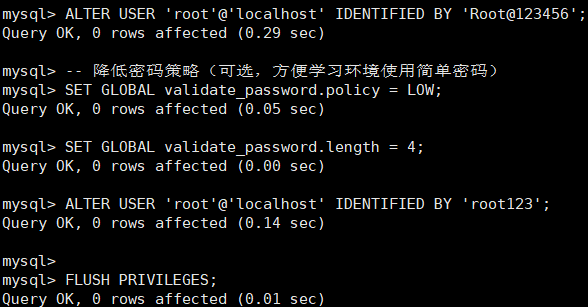
1.5 创建 Hive 元数据库和用户
-- 创建hive数据库
CREATE DATABASE hive DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

-- 创建hive用户并授权(允许所有主机连接)
CREATE USER 'hive'@'%' IDENTIFIED BY 'hive123';
GRANT ALL PRIVILEGES ON hive.* TO 'hive'@'%';

-- 同时给localhost也创建
CREATE USER 'hive'@'localhost' IDENTIFIED BY 'hive123';
GRANT ALL PRIVILEGES ON hive.* TO 'hive'@'localhost';

FLUSH PRIVILEGES;

-- 验证
SHOW DATABASES;

EXIT;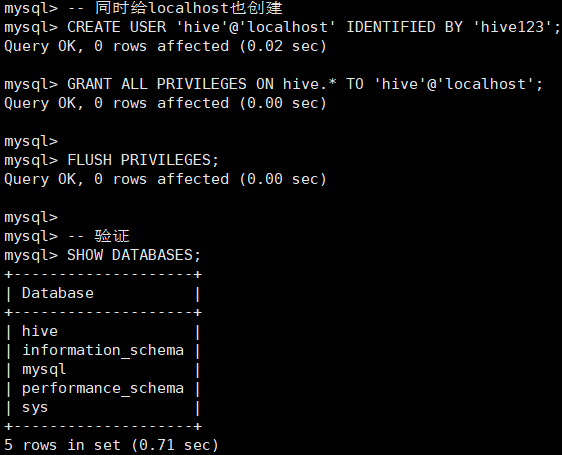
第二步:安装 Hive 3.1.3(Master节点)
2.1 解压安装包
cd /opt
tar -zxvf apache-hive-3.1.3-bin.tar.gz -C /usr/local/
cd /usr/local/
mv apache-hive-3.1.3-bin hive
2.2 配置环境变量
vim /etc/profile在文件末尾添加:
# Hive
export HIVE_HOME=/usr/local/hive
export PATH=$PATH:$HIVE_HOME/binsource /etc/profile
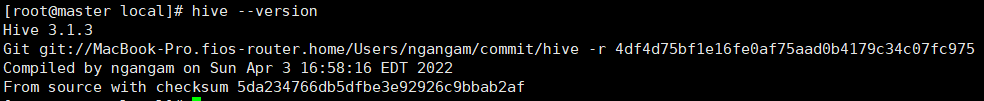
# 验证
hive --version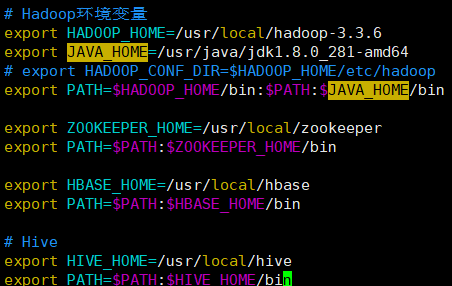
2.3解决 SLF4J 冲突
Hadoop 和 Hive 都自带了 SLF4J 日志绑定包,保留 Hadoop 的,备份 Hive 的:
# 在 Master 执行
mv /usr/local/hive/lib/log4j-slf4j-impl-2.17.1.jar /usr/local/hive/lib/log4j-slf4j-impl-2.17.1.jar.bak*【提示】 操作后再次执行 hive --version,启动时的 SLF4J 警告会消失。
2.4 上传 MySQL JDBC 驱动
# 假设你的 jar 包在 /opt/ 目录下
cp /opt/mysql-connector-java-8.0.21.jar /usr/local/hive/lib/
2.5 解决Guava版本冲突(重要!)
Hive 3.1.3 自带的 guava 版本与 Hadoop 3.3.6 不兼容,必须处理:
# 查看版本
ls /usr/local/hive/lib/guava*.jar
ls /usr/local/hadoop-3.3.6/share/hadoop/common/lib/guava*.jar

# Hadoop用的是guava-27.0,Hive自带的是guava-19.0,需要替换
rm /usr/local/hive/lib/guava-19.0.jar
cp /usr/local/hadoop-3.3.6/share/hadoop/common/lib/guava-27.0-jre.jar /usr/local/hive/lib/
第三步:配置 Hive
3.1 进入配置目录
cd /usr/local/hive/conf3.2 创建 hive-site.xml
vim hive-site.xml粘贴以下完整内容:
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
<!-- MySQL连接配置 -->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://master:3306/hive?useSSL=false&useUnicode=true&characterEncoding=UTF-8&allowPublicKeyRetrieval=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>hive</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>hive123</value>
</property>
<!-- 元数据自动创建/更新 -->
<property>
<name>datanucleus.schema.autoCreateAll</name>
<value>true</value>
</property>
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
<!-- Metastore配置 -->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<property>
<name>hive.metastore.uris</name>
<value>thrift://master:9083</value>
</property>
<!-- HiveServer2配置 -->
<property>
<name>hive.server2.thrift.port</name>
<value>10000</value>
</property>
<property>
<name>hive.server2.thrift.bind.host</name>
<value>master</value>
</property>
<property>
<name>hive.server2.enable.doAs</name>
<value>false</value>
</property>
<!-- 显示数据库名和列名 -->
<property>
<name>hive.cli.print.header</name>
<value>true</value>
</property>
<property>
<name>hive.cli.print.current.db</name>
<value>true</value>
</property>
</configuration>3.3 配置 hive-env.sh
cp hive-env.sh.template hive-env.sh
vim hive-env.sh
添加以下内容:
export JAVA_HOME=/usr/java/jdk1.8.0_281-amd64
export HADOOP_HOME=/usr/local/hadoop-3.3.6
export HIVE_HOME=/usr/local/hive
export HIVE_CONF_DIR=/usr/local/hive/conf
export HIVE_AUX_JARS_PATH=/usr/local/hive/lib
# 增加 Hadoop 基础堆内存
export HADOOP_HEAPSIZE=1024
五、配置 Hadoop 代理用户(重要!)
HiveServer2 需要 Hadoop 开启代理用户权限,否则将卡死在启动阶段:
vim /usr/local/hadoop-3.3.6/etc/hadoop/core-site.xml在 </configuration> 前添加:
<property>
    <name>hadoop.proxyuser.root.hosts</name>
    <value>*</value>
</property>
<property>
    <name>hadoop.proxyuser.root.groups</name>
    <value>*</value>
</property>
*【注意】* 修改 core-site.xml 后必须重启 Hadoop(stop-all.sh && start-all.sh)才能生效。
第四步:初始化元数据库
4.1 在 HDFS 上创建 Hive 目录
hadoop fs -mkdir -p /user/hive/warehouse
hadoop fs -mkdir -p /tmp/hive
hadoop fs -chmod 777 /user/hive/warehouse
hadoop fs -chmod 777 /tmp/hive
# 2. 再次确保 HDFS 路径权限全开
hadoop fs -chmod -R 777 /tmp
4.2 初始化 Schema(重要!)
schematool -dbType mysql -initSchema正常输出最后显示:
Initialization script completed
schemaTool completed
❌ 如果报错
com.mysql.cj.jdbc.Driver not found,检查 jar 是否放到了/usr/local/hive/lib/❌ 如果报错连接拒绝,检查 MySQL 是否启动、用户名密码是否正确
第五步:启动 Hive 服务
*【提示】* 必须先启动 MetaStore,等待其完全就绪(9083端口监听)后,再启动 HiveServer2。
5.1 启动 Metastore 服务(后台运行)
# 前台启动(测试用)
# hive --service metastore

# 后台启动(推荐)
# 先创建logs目录
mkdir -p /usr/local/hive/logs

nohup hive --service metastore > /usr/local/hive/logs/metastore.log 2>&1 &
echo "MetaStore PID: $!"

# 等待15秒启动完成
sleep 15

# 验证9083端口
netstat -nltp | grep 9083
#成功标志:netstat 输出中显示 9083 端口处于 LISTEN 状态。

tail -f /usr/local/hive/logs/metastore.log
# 看到 "Started MetaStore Server" 即成功,Ctrl+C 退出 tail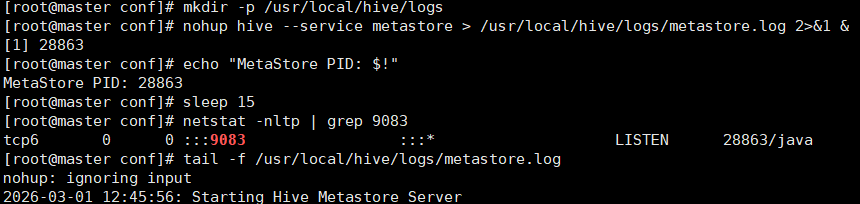
5.2 启动 HiveServer2(后台运行)
nohup hive --service hiveserver2 > /usr/local/hive/logs/hiveserver2.log 2>&1 &
echo "HiveServer2 PID: $!"

# 等待30秒启动完成
sleep 30

# 验证10000端口已监听
netstat -nltp | grep 10000
#成功标志:netstat 输出中显示 10000 端口处于 LISTEN 状态。
tail -f /usr/local/hive/logs/hiveserver2.log
# 看到 "New Hive Server2 started" 即成功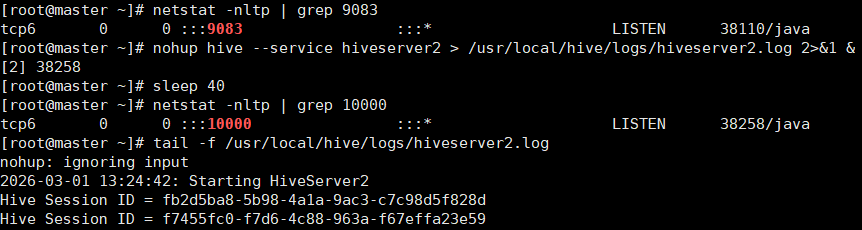
5.3 验证进程
jps
# 应能看到 RunJar(两个,分别对应metastore和hiveserver2)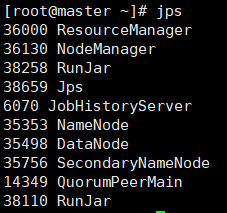
第六步:测试 Hive
6.1 使用 Hive CLI 测试
hive在 hive> 提示符下执行:
SHOW DATABASES;
CREATE DATABASE test;
USE test;
CREATE TABLE student (id INT, name STRING) ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';
SHOW TABLES;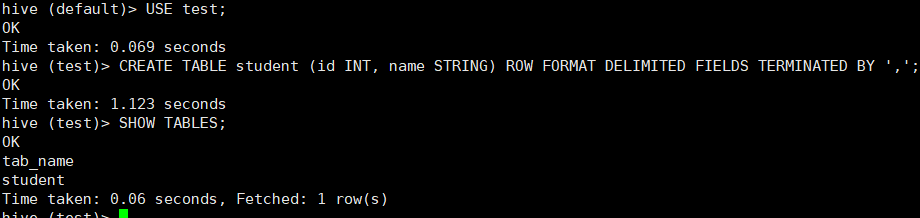
6.2 使用 Beeline 连接 HiveServer2 测试
beeline -u "jdbc:hive2://master:10000" -n root在 beeline 提示符下执行:
SHOW DATABASES;
USE test;
SELECT * FROM student;

!quit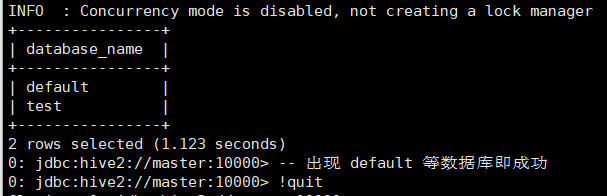
第七步:编写启动脚本(可选)
创建启动脚本:
vim /usr/local/hive/bin/start-hive.sh#!/bin/bash
echo "========== 启动 Metastore =========="
nohup hive --service metastore > /usr/local/hive/logs/metastore.log 2>&1 &
sleep 10
echo "========== 启动 HiveServer2 =========="
nohup hive --service hiveserver2 > /usr/local/hive/logs/hiveserver2.log 2>&1 &
echo "========== Hive 启动完成 =========="
jps创建停止脚本:
vim /usr/local/hive/bin/stop-hive.sh#!/bin/bash
echo "========== 停止 Hive 服务 =========="
ps -ef | grep HiveMetaStore | grep -v grep | awk '{print $2}' | xargs kill -9
ps -ef | grep HiveServer2 | grep -v grep | awk '{print $2}' | xargs kill -9
echo "========== 停止完成 =========="chmod +x /usr/local/hive/bin/start-hive.sh
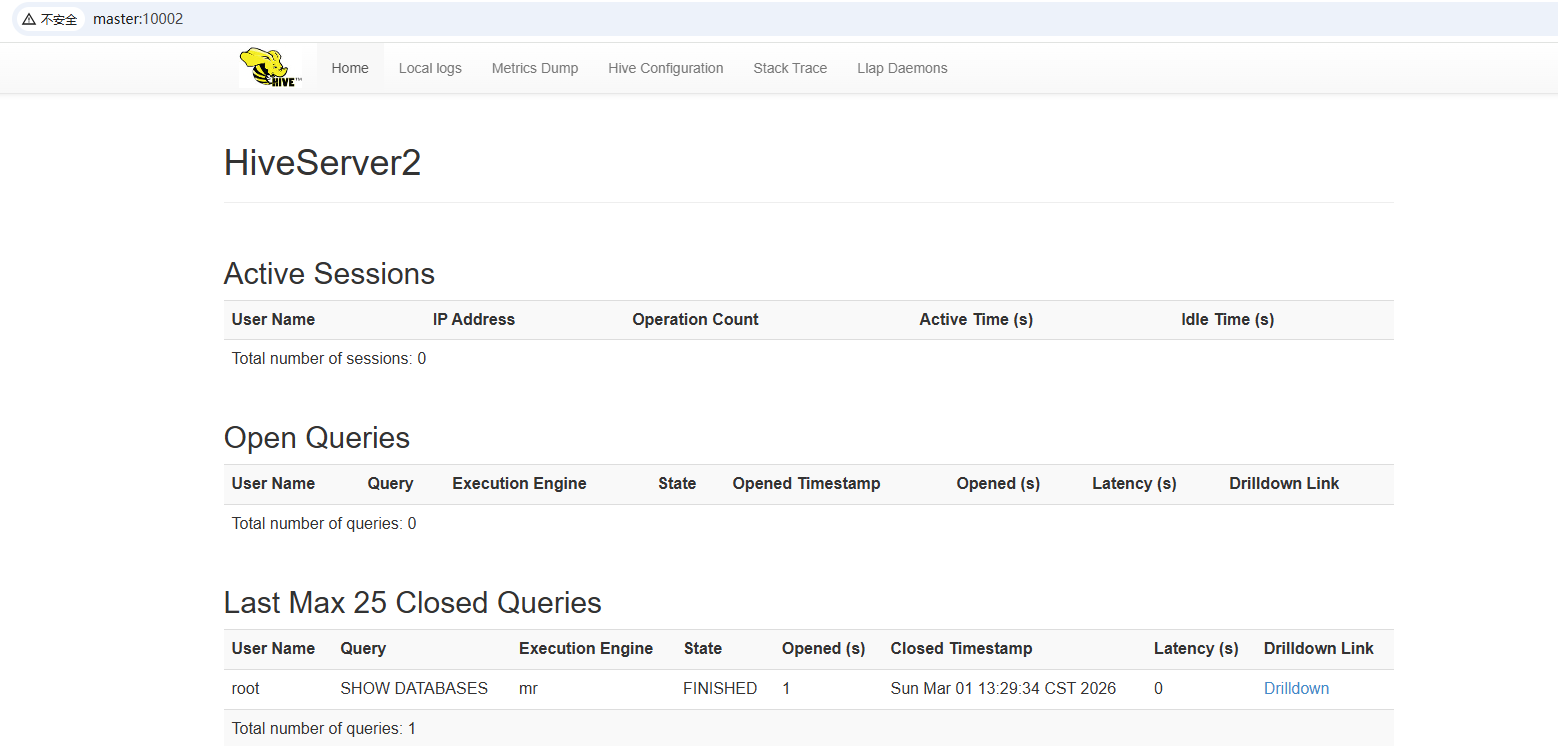
chmod +x /usr/local/hive/bin/stop-hive.sh7.3 访问 HiveServer2 Web UI
浏览器访问:http://master:10002/
常见问题排查
| *报错信息* | *原因* | *解决方案* |
|---|---|---|
| ClassNotFoundException: com.mysql.cj.jdbc.Driver | JDBC 驱动未放到 lib | cp 驱动到 /usr/local/hive/lib/ |
| Incompatible Guava / NoSuchMethodError | Guava 版本冲突 | 用 Hadoop 的 guava-27.0 替换 Hive 的 guava-19.0 |
| Connection refused 3306 | MySQL 未启动 | systemctl start mysqld |
| Public Key Retrieval not allowed | MySQL8 连接参数问题 | URL 中加 allowPublicKeyRetrieval=true |
| Address already in use :9083 | MetaStore 已有实例运行 | kill 旧进程后重启 |
| HiveServer2 卡死无法启动 | core-site.xml 缺少代理用户配置 | 添加 hadoop.proxyuser.root.* 后重启 Hadoop |
| HDFS 权限拒绝 | warehouse 目录权限不足 | hadoop fs -chmod -R 777 /user/hive /tmp |
| Access denied for user hive | MySQL hive 用户密码不一致 | 重建 MySQL 用户或修改 hive-site.xml 密码 |
九、集群服务总览
| *服务* | *端口* | *节点* | *说明* |
|---|---|---|---|
| NameNode | 9870 | master | HDFS Web UI |
| ResourceManager | 8088 | master | YARN Web UI |
| HMaster | 16010 | master | HBase Web UI |
| ZooKeeper | 2181 | master/slave1/slave2 | ZK 客户端端口 |
| Hive MetaStore | 9083 | master | Thrift 元数据服务 |
| HiveServer2 | 10000 | master | JDBC/ODBC 接入点 |
| HiveServer2 WebUI | 10002 | master | Hive Web 管理界面 |